Lavoro · 2026
Verbris: come ho creato un gioco in un mese usando l'IA
828 commit tra il 4 giugno e il 2 settembre 2026, nessuno scritto a mano. Com'è nato Verbris, browser game a metà tra Ruzzle e Tetris, e tutto quello che ho costruito e poi cancellato.
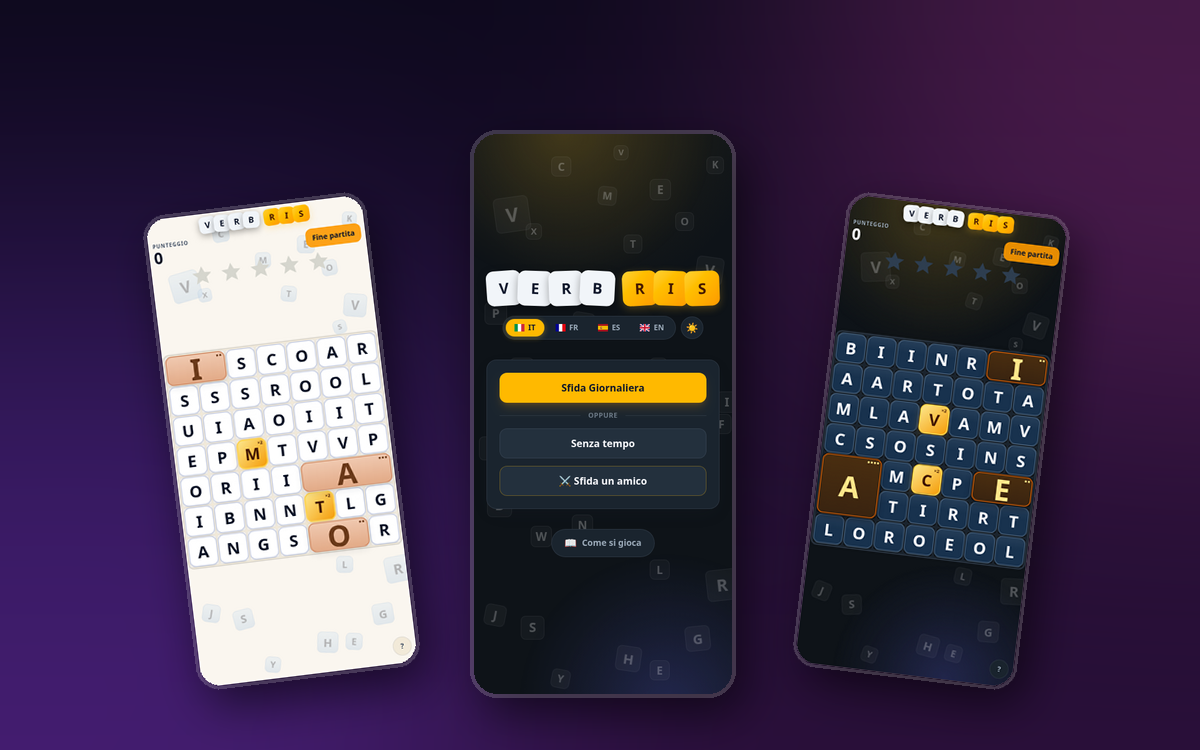
Le date che leggi qui sono quelle dei commit: 828, dal 4 giugno al 2 settembre 2026. Le immagini non sono mockup. Ho fatto girare il codice com’era in ciascuna tappa e ho catturato lo schermo.
Il punto di partenza
Il 4 giugno 2026 apro un editor e comincio Verbris, un browser game a metà fra Ruzzle e Tetris. Da Ruzzle prende le parole formate muovendosi su lettere adiacenti, da Tetris la gravità: quando elimini una parola le lettere sopra cadono, e una griglia di riserva nascosta rifornisce dall’alto. Due giorni dopo era online per davvero, con deploy su Vercel e Railway.
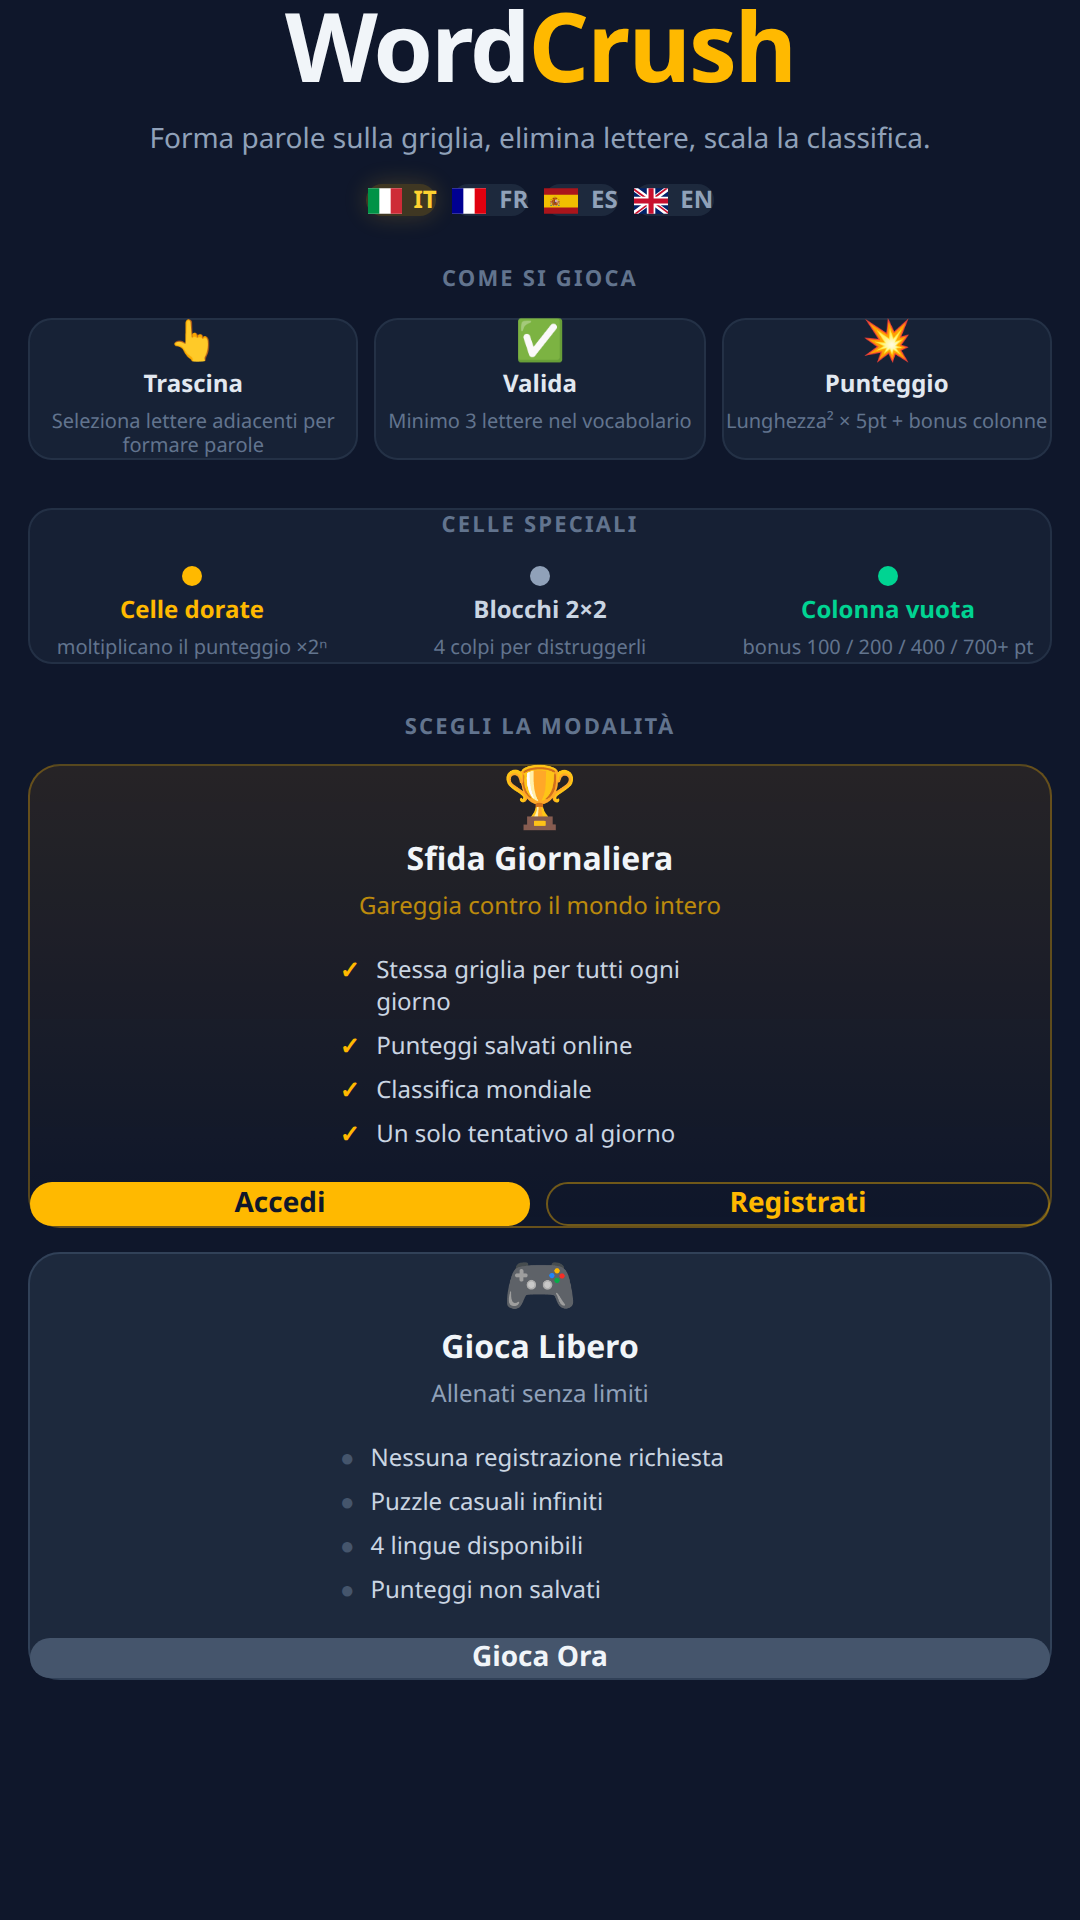 La primissima versione pubblicata. Il gioco si chiamava ancora WordCrush e si giocava trascinando il dito sulle lettere.
Nel titolo scrivo “un mese” perché giugno è bastato: a fine mese il gioco aveva account, statistiche, classifiche, un generatore di puzzle in quattro lingue e un server che, invece di fidarsi del punteggio ricevuto, rigioca la partita per verificarlo. Quello che è successo da luglio in poi è stato un lavoro di natura diversa, e cioè decidere cosa di quel primo mese meritava di restare. È la parte che mi interessa di più raccontare.
Di righe di codice non ne ho scritta nessuna. Tutti e 828 i commit sono usciti da un’agente IA, Claude Code, a cui davo istruzioni, di cui leggevo i diff e a cui rimandavo indietro il lavoro quando non mi convinceva. Non gli ho chiesto “fammi un gioco”: gli ho chiesto una specifica alla volta. Parto dal metodo perché senza quello i numeri qui sotto valgono poco.
Il metodo: quarantacinque volte lo stesso giro
Nel repository ci sono 45 documenti di specifica, 45 piani di implementazione e 16 audit del codice, scritti prima o subito dopo il codice a cui si riferiscono. Il giro è sempre quello:
- Una specifica in italiano, cosa deve succedere e perché, prima di aprire un file. Per dire:
2026-06-12-daily-session-anticheat-design.md,2026-07-06-modello-rituale-design.md. - Un piano che spezza la specifica in passi, con l’elenco dei file coinvolti.
- L’implementazione, che scrive l’IA e che rivedo diff per diff.
- Ogni tanto un audit, cioè una passata dedicata solo a cercare codice morto, duplicazioni e complicazioni inutili. L’ultimo è del 30 agosto.
- La verifica, che non è “mi sembra che funzioni”: 463 test sul frontend, 16 sul backend, type-check, lint, e per il generatore di puzzle un controllo di non regressione (
pnpm gen:golden) che deve restare verde a impronta invariata.
Se salti la specifica, un’IA ti scrive lo stesso il codice, e pure in fretta. Il problema arriva tre settimane dopo, quando quel codice funziona ancora ma nessuno, tu compreso, sa più dire perché una certa regola è scritta così. La chat che l’ha prodotto è chiusa da un pezzo. La specifica resta.
Giugno, i 459 commit fondativi
Il primo problema serio arriva dopo tre giorni: il trascinamento del mouse, sullo schermo del telefono, è scomodo. Il 7 giugno il gioco passa al tap-to-play e la home viene ridisegnata. Da lì smette di essere un esperimento da scrivania.
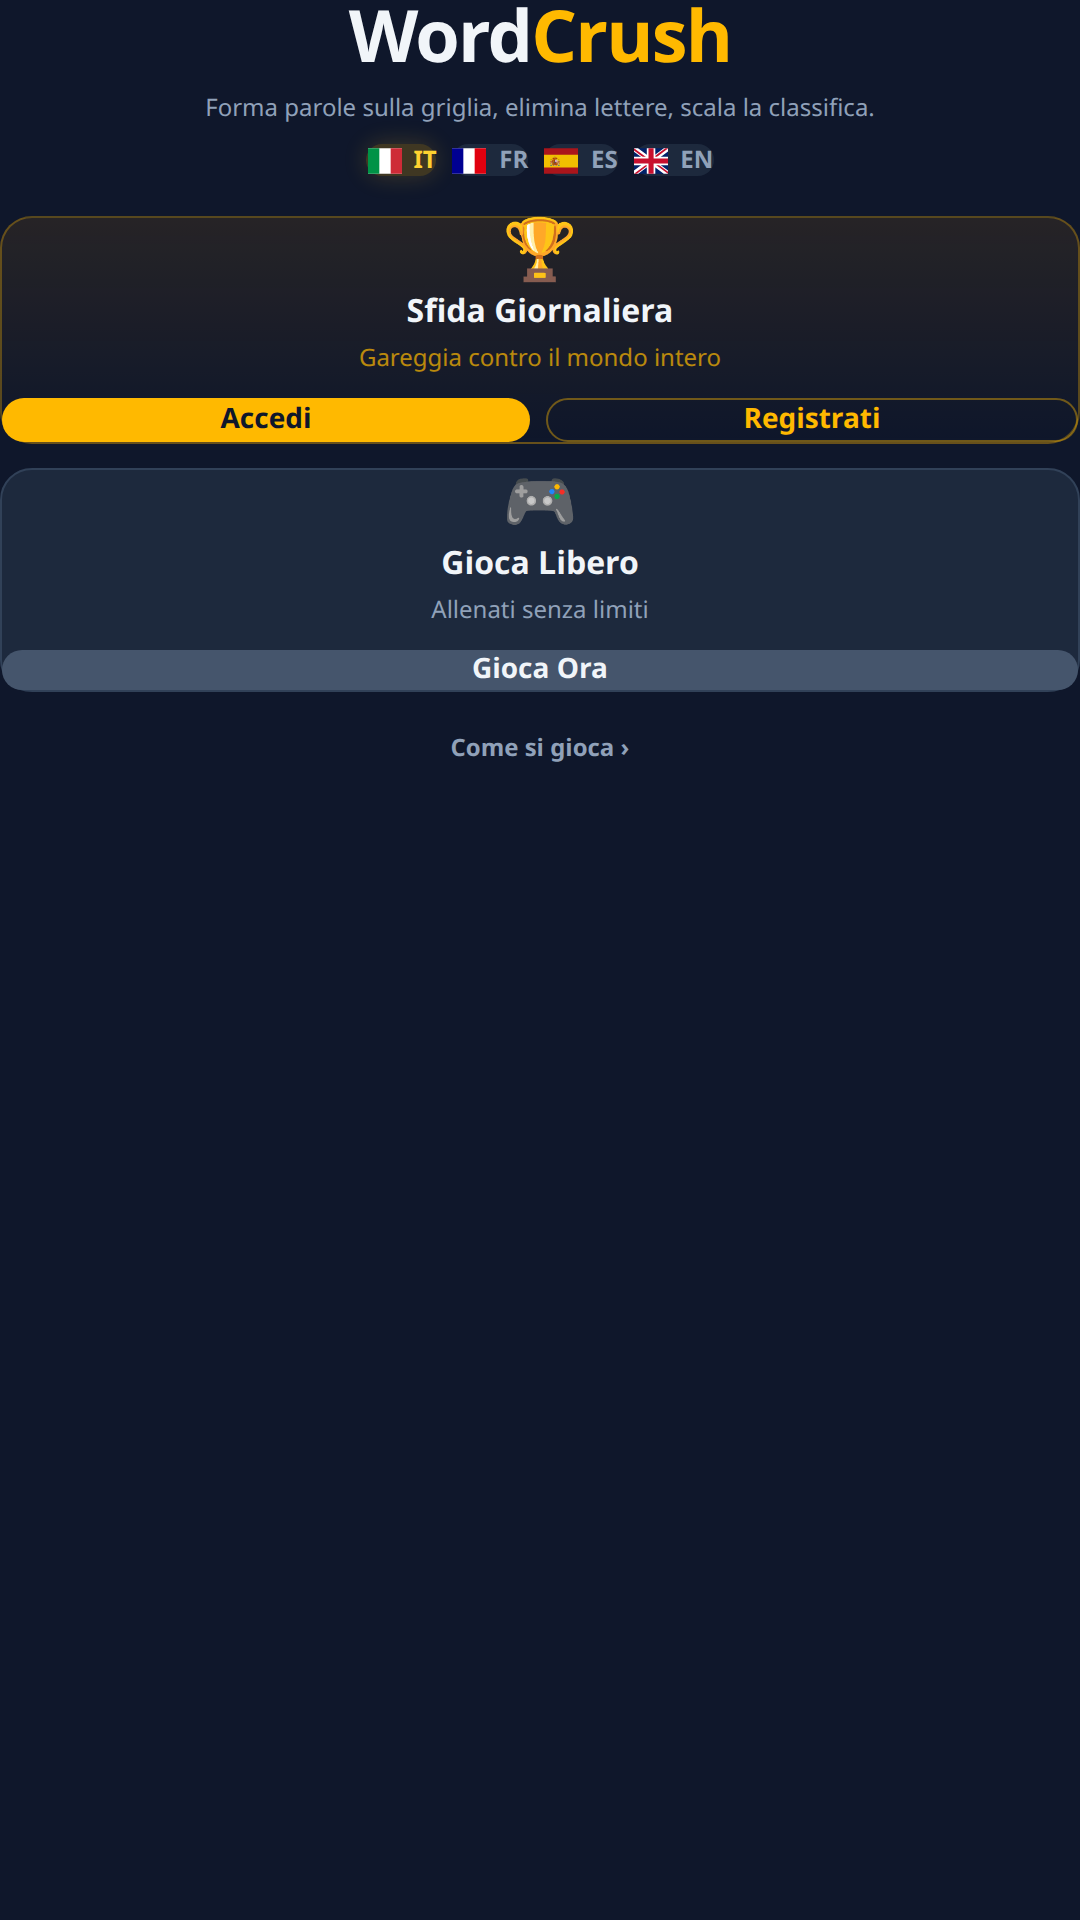 Dopo il tap-to-play: layout compattato e “Come si gioca” spostato in un pannello a comparsa, invece di occupare spazio fisso.
Il mese poi accelera. Arrivano le statistiche giocatore, le classifiche globali, gli amici, l’autenticazione, un popup di fine partita sempre più elaborato, gli effetti sonori generativi. Il 18 giugno c’è un redesign completo dell’interfaccia: design token dichiarati una volta sola con @theme di Tailwind, celle con più stati visivi, timer con barra invece del solo testo, onboarding contestuale che non blocca il gioco.
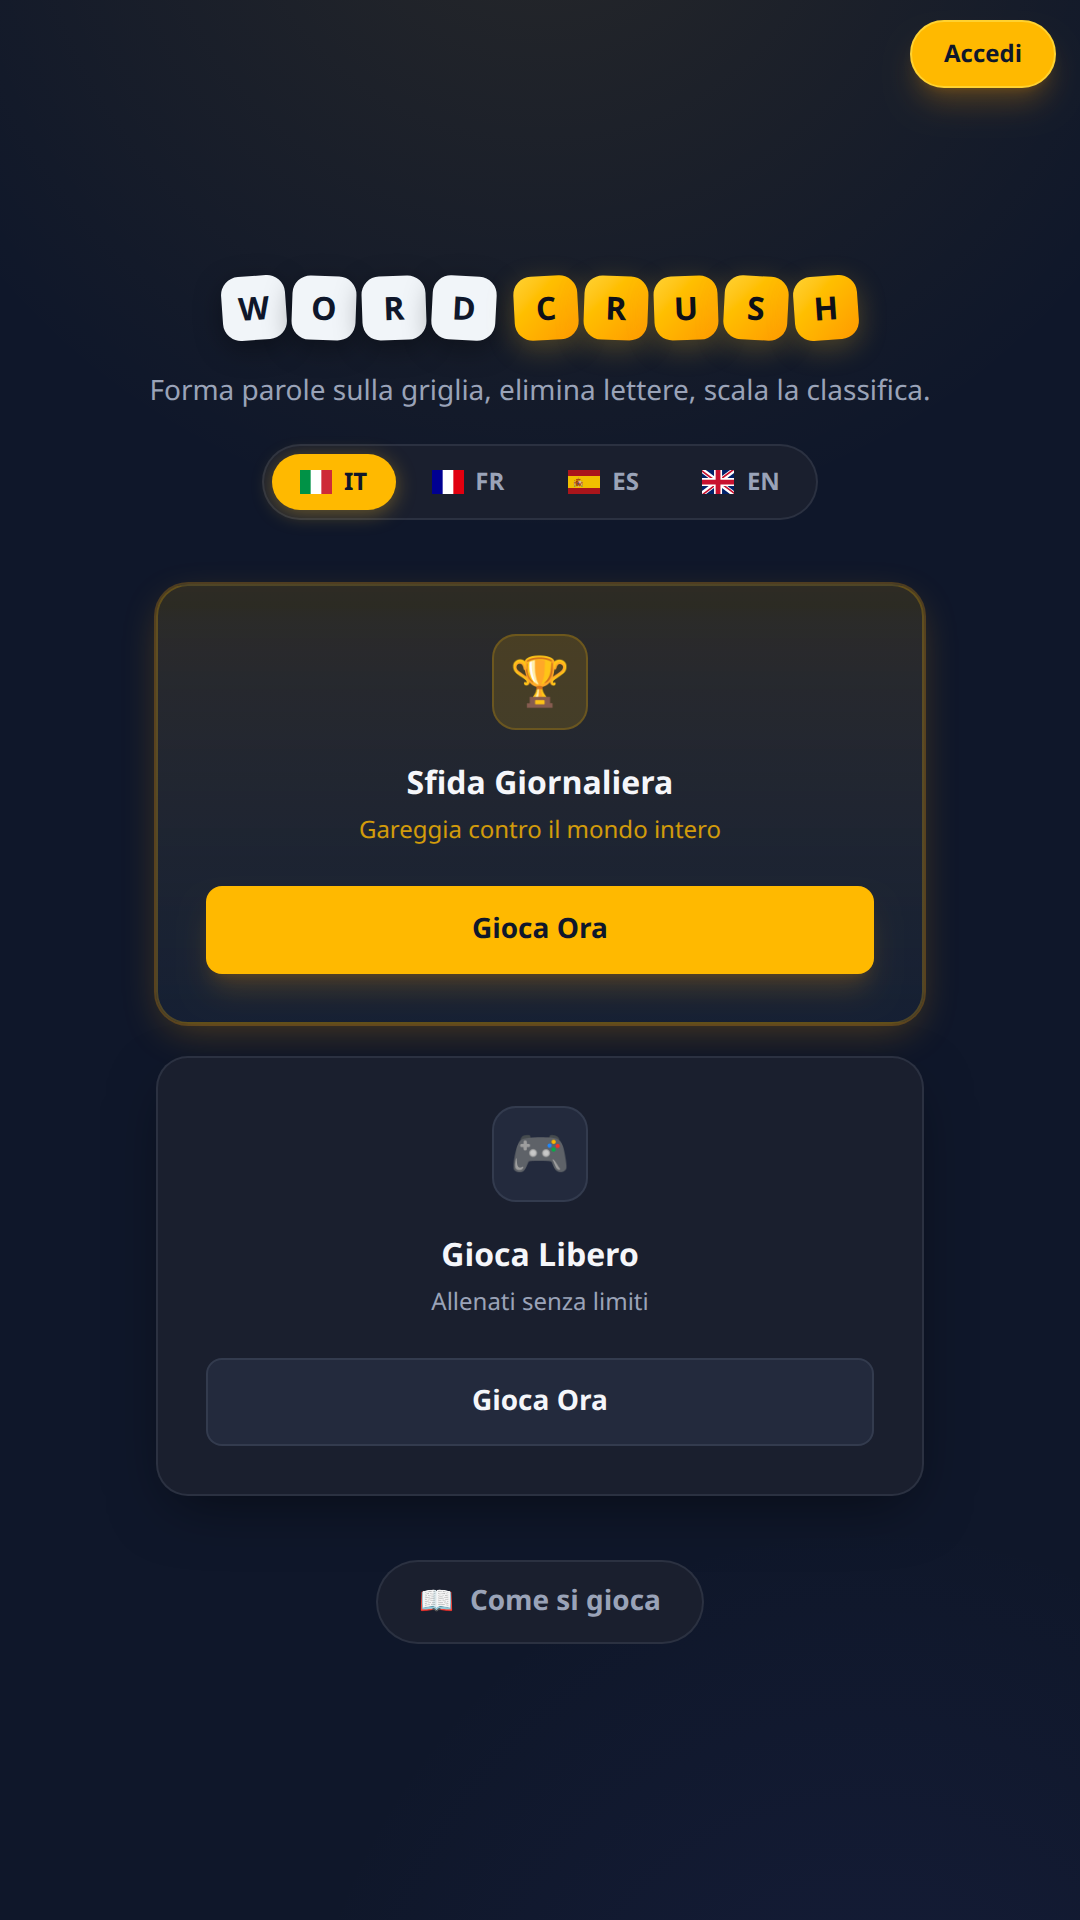 Il redesign del 18 giugno. Il nome è ancora WordCrush e in alto a destra c’è ancora il pulsante “Accedi”.
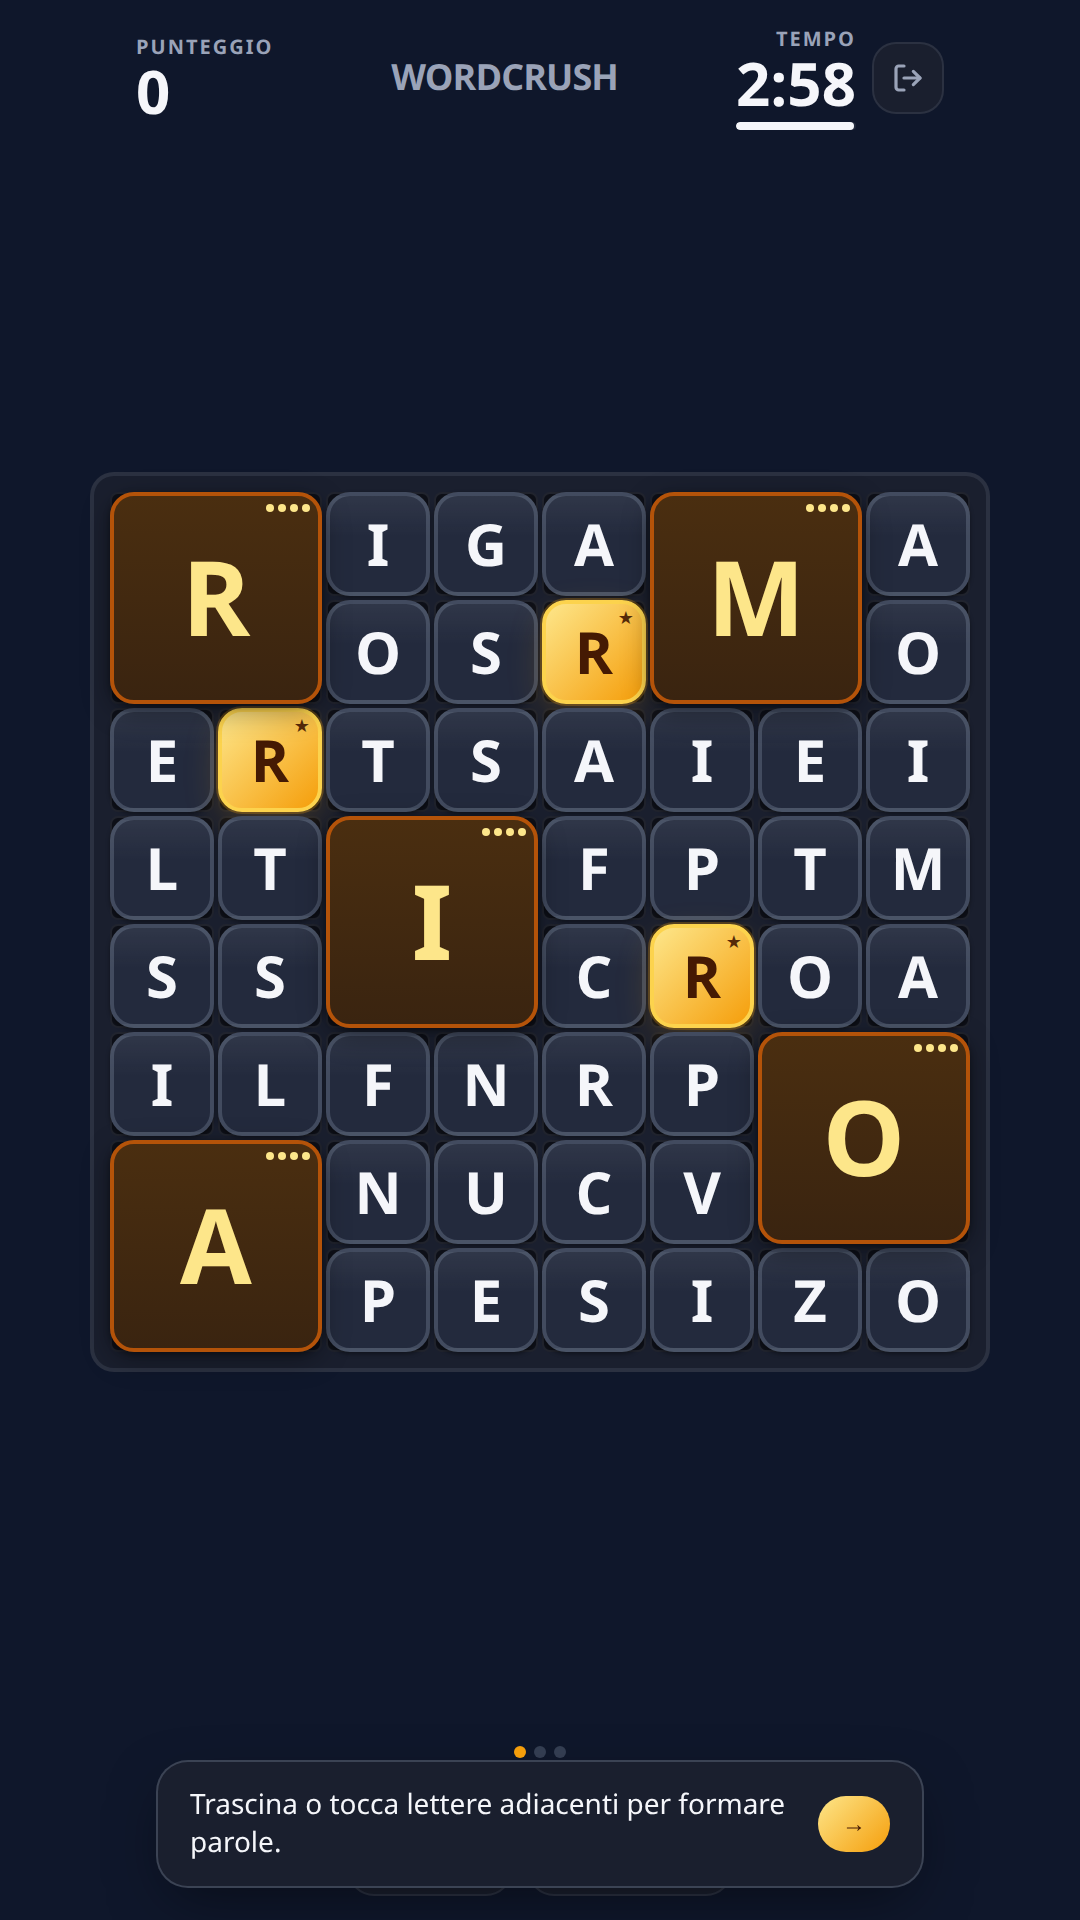 La griglia nello stesso periodo: timer con barra colorata, blocchi 2×2, celle dorate, onboarding ancora in sovraimpressione.
Sotto la superficie però il commit che conta più di ogni redesign è quello del 20 giugno, replayRun condiviso. Da lì in poi il server smette di calcolare il punteggio a modo suo: rigioca le mosse che riceve con lo stesso motore del client, e se il risultato non torna scarta la partita. Client e server eseguono lo stesso codice, non due implementazioni parallele della stessa regola. Ha governato ogni feature successiva.
Il 30 giugno, un mese esatto dopo il lancio, il gioco cambia nome. Da WordCrush a Verbris, con trasferimento sul nuovo dominio. Rinominare un prodotto già online e con utenti veri costa: link condivisi che si rompono, indicizzazione da rifare, riconoscibilità azzerata. L’ho fatto perché WordCrush suonava come il clone di qualcos’altro, mentre Verbris (da verbum) portava dentro l’identità multilingua che il gioco stava prendendo.
Roba che ho costruito e poi cancellato
Nei case study questa parte di solito non c’è, e secondo me è quella che insegna di più quando lavori con un’IA che scrive codice a quella velocità. Se la salto sembra che ogni decisione sia stata giusta al primo colpo, e non è andata così.
Login, amici e classifica globale: giugno, poi cancellati il 15 agosto
A giugno il gioco aveva account, autenticazione, inviti fra amici e una classifica mondiale.
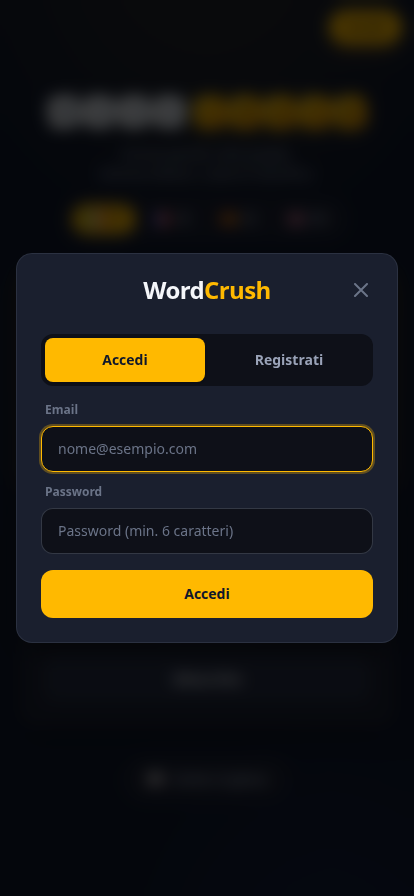 Il modale di accesso e registrazione. Oggi non è più raggiungibile: il codice che lo produceva è stato eliminato, non solo nascosto.
Il 6 luglio, un mese dopo averlo costruito, ho deciso di rinunciare alla classifica mondiale e all’identità persistente. Il motivo è tecnico. Una classifica globale seria ha bisogno di un anti-cheat robusto, altrimenti basta cambiare dispositivo o svuotare la cache per mandarci dentro un punteggio inventato. Quell’anti-cheat erano settimane di lavoro, e servivano a trasformare tre minuti di rituale quotidiano in una gara. Verbris non volevo che fosse quello.
Cinque settimane dopo, il 15 agosto, ho fatto la cosa che di solito si rimanda: invece di nascondere login, amici e classifica dietro un flag, li ho eliminati dal codice. Circa 1300 righe, cancellate. Tenerle lì “per dopo, non si sa mai” è il modo più comune di accumulare codice morto che poi nessuno osa più toccare.
La classifica del primo tentativo, durata una serata
Sempre il 6 luglio, prima di arrivare al modello definitivo (conta il punteggio migliore, ritentativi illimitati), ho fatto implementare l’alternativa che sembrava più onesta: conta solo il primo tentativo della giornata, e chi vuole rigiocare lo fa in una modalità Allenamento separata. L’ho vista funzionare e l’ho buttata la sera stessa. Senza identità verificata, “conta solo il primo tentativo” si aggira come qualsiasi classifica, cambiando dispositivo. Metteva attrito a chi gioca onestamente senza fermare nessun altro.
La classifica globale, cinque giorni di vita
Il 10 giugno il popup di fine partita guadagna un toggle Ufficiale/Migliore per confrontarsi con i punteggi globali. Il 15 giugno, passando al modello “conta il migliore”, quel confronto non voleva più dire niente, e mischiare tentativi ufficiali e liberi in una classifica sola confondeva e basta. Via il toggle e via lo store leaderboard che lo alimentava.
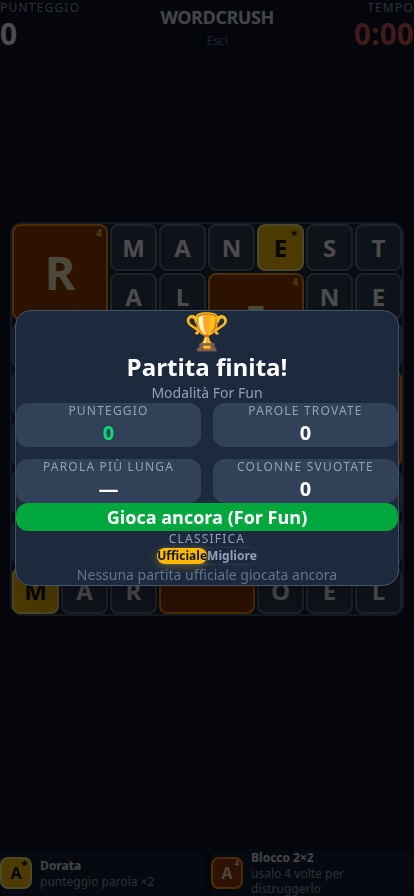 Il popup di fine partita del 10 giugno con il toggle della classifica globale: costruito il 10, rimosso il 15.
Il popup di conferma d’uscita, tre giorni
Il 12 giugno costruisco un anti-cheat per la partita giornaliera, con una finestra temporale lato server e un popup che chiede conferma prima di uscire a metà (uscire valeva come invio parziale). Lo rimuovo il 15 insieme all’invio parziale: nel frattempo il modello era diventato “conta il migliore”, quindi uscendo a metà non perdevi più niente e quella conferma era solo un ostacolo. Un pezzo di interfaccia sensatissimo il lunedì diventa fastidio il giovedì, se sotto gli cambi il modello.
I video promozionali con il bot
Ad agosto ho fatto costruire una pipeline che generava clip promozionali con mosse del bot in tre varianti (quiz, community, playout). Sono rimaste in produzione un po’, poi le ho tolte. La clip che pilota l’app vera, con il timer che scorre e una mossa vera, funzionava meglio del bot che finge di giocare.
La sfida via link, il multiplayer anonimo nato lo stesso giorno
Il 6 luglio non è stato solo togliere. Lo stesso giorno in cui butto la classifica mondiale costruisco quello che la sostituisce per l’uso che contava davvero, cioè sfidare gli amici e non il mondo intero. Crei una sfida, mandi un URL, chi lo apre gioca la stessa identica griglia e finisce in una mini classifica. Nessuno sa chi sono i giocatori, nemmeno il server.
L’identità è un token che il server genera al primo contatto e il client salva in localStorage. Non è un account, è solo un modo per riconoscere che questo è lo stesso dispositivo della sfida precedente. Se il token manca o non è più valido, il server ne fa un altro senza chiedere niente.
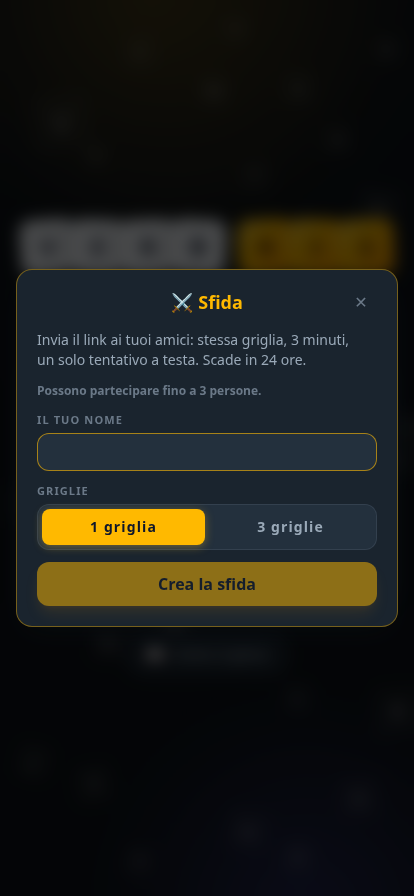 La modale della sfida oggi: nickname, numero di griglie e il limite di prodotto scritto in chiaro, tre partecipanti.
Il punteggio passa dallo stesso motore della giornaliera: il client manda le mosse e non il totale, e il server le rigioca con replayRun. Non esiste una versione più permissiva per le sfide. Anche il determinismo segue la stessa strada, con le celle dorate che rinascono da un seed calcolato in game-core con la formula della daily, così tutti vedono la griglia evolvere allo stesso modo.
Qui però c’è un attacco che la giornaliera non ha: apri il link, studi la griglia con calma senza cronometro addosso, e cominci a giocare solo dopo, dichiarando un tempo falso. La difesa è un marcatore. Il server consuma la griglia, cioè scrive che quella partita è iniziata e non ancora inviata, nell’istante in cui il client la chiede per giocarla e non quando gliela mostra. Da lì parte una finestra di tempo fissa, e abbandonare senza inviare lascia zero. Una revisione dedicata alla modalità, il 16 agosto, ha scoperto che nella prima versione la richiesta pubblica usata per mostrare classifica e countdown restituiva comunque la griglia completa, riaprendo la finestra di studio che il marcatore doveva chiudere. Corretto spostando quel pezzo di risposta nella sola richiesta che consuma davvero il marcatore.
Una precisazione che devo a chi legge: ogni sfida ammette fino a tre giocatori. È un limite di prodotto, non tecnico, perché la tabella dei punteggi è una riga per giocatore per sfida e non ha nessun motivo strutturale per fermarsi lì. Sfidare un amico era pensato per un gruppetto che si conosce, non per un torneo pubblico, che avrebbe richiesto lo stesso anti-cheat per cui poche righe sopra ho scartato la classifica mondiale.
Le due regole che non ho più toccato
Due vincoli sono diventati intoccabili al punto da avere una sezione dedicata nella guida che l’IA legge all’inizio di ogni sessione.
Il primo: client e server condividono il codice. game-core, il pacchetto che decide se una mossa è valida e quanto vale, è importato tanto dal frontend quanto dal backend. Se il client applicasse un bonus che il server non conosce, il replay scarterebbe ogni partita legittima. La regola vive in un posto solo e la chiamano in due.
Il secondo: il determinismo. La stessa giornata deve produrre la stessa identica griglia per tutti, nella stessa lingua, e il replay del server deve consumare la stessa sequenza casuale che ha visto il client. L’RNG seedato sta in un unico modulo, nei percorsi che contano non c’è un solo Math.random(), e nemmeno il generatore offline guarda mai l’orologio.
Una terza regola è arrivata più tardi, da un bug vero: ad agosto lo stato di Cruciverbris sopravviveva dentro la giornaliera classica, che si ritrovava indizi e regole non suoi. Da lì la scelta di trattare le modalità come dati, con otto tabelle Record<GameMode, …> per campi, comportamento, schermate, menu, tutorial e fine partita. Se aggiungo una modalità e dimentico una riga, il compilatore TypeScript si rifiuta di compilare. Non è eleganza: è un modo per rendere quel bug impossibile una seconda volta.
C’entra con l’IA più di quanto sembri. Un’agente rispetta molto meglio un invariante che il compilatore controlla di quanto rispetti un’istruzione ripetuta a voce in ogni chat. Un Record<GameMode, …> vale dieci righe di CLAUDE.md.
Agosto, 335 commit e quattro lingue
Agosto è il secondo mese più intenso, quello in cui il gioco smette di essere un puzzle e diventa un piccolo insieme di modalità sullo stesso motore.
Le modalità diventano cinque. Cruciverbris e il percentile di fine giornata hanno una sezione loro qui sotto. Verbr-Flip gira le lettere invece di eliminarle, senza gravità: è completa e testata, ma sta fuori dal menu, nascosta da una riga di codice (visible: () => false). Non è lavoro incompiuto, è un rilascio rimandato, che è un’altra cosa rispetto alle rimozioni di prima.
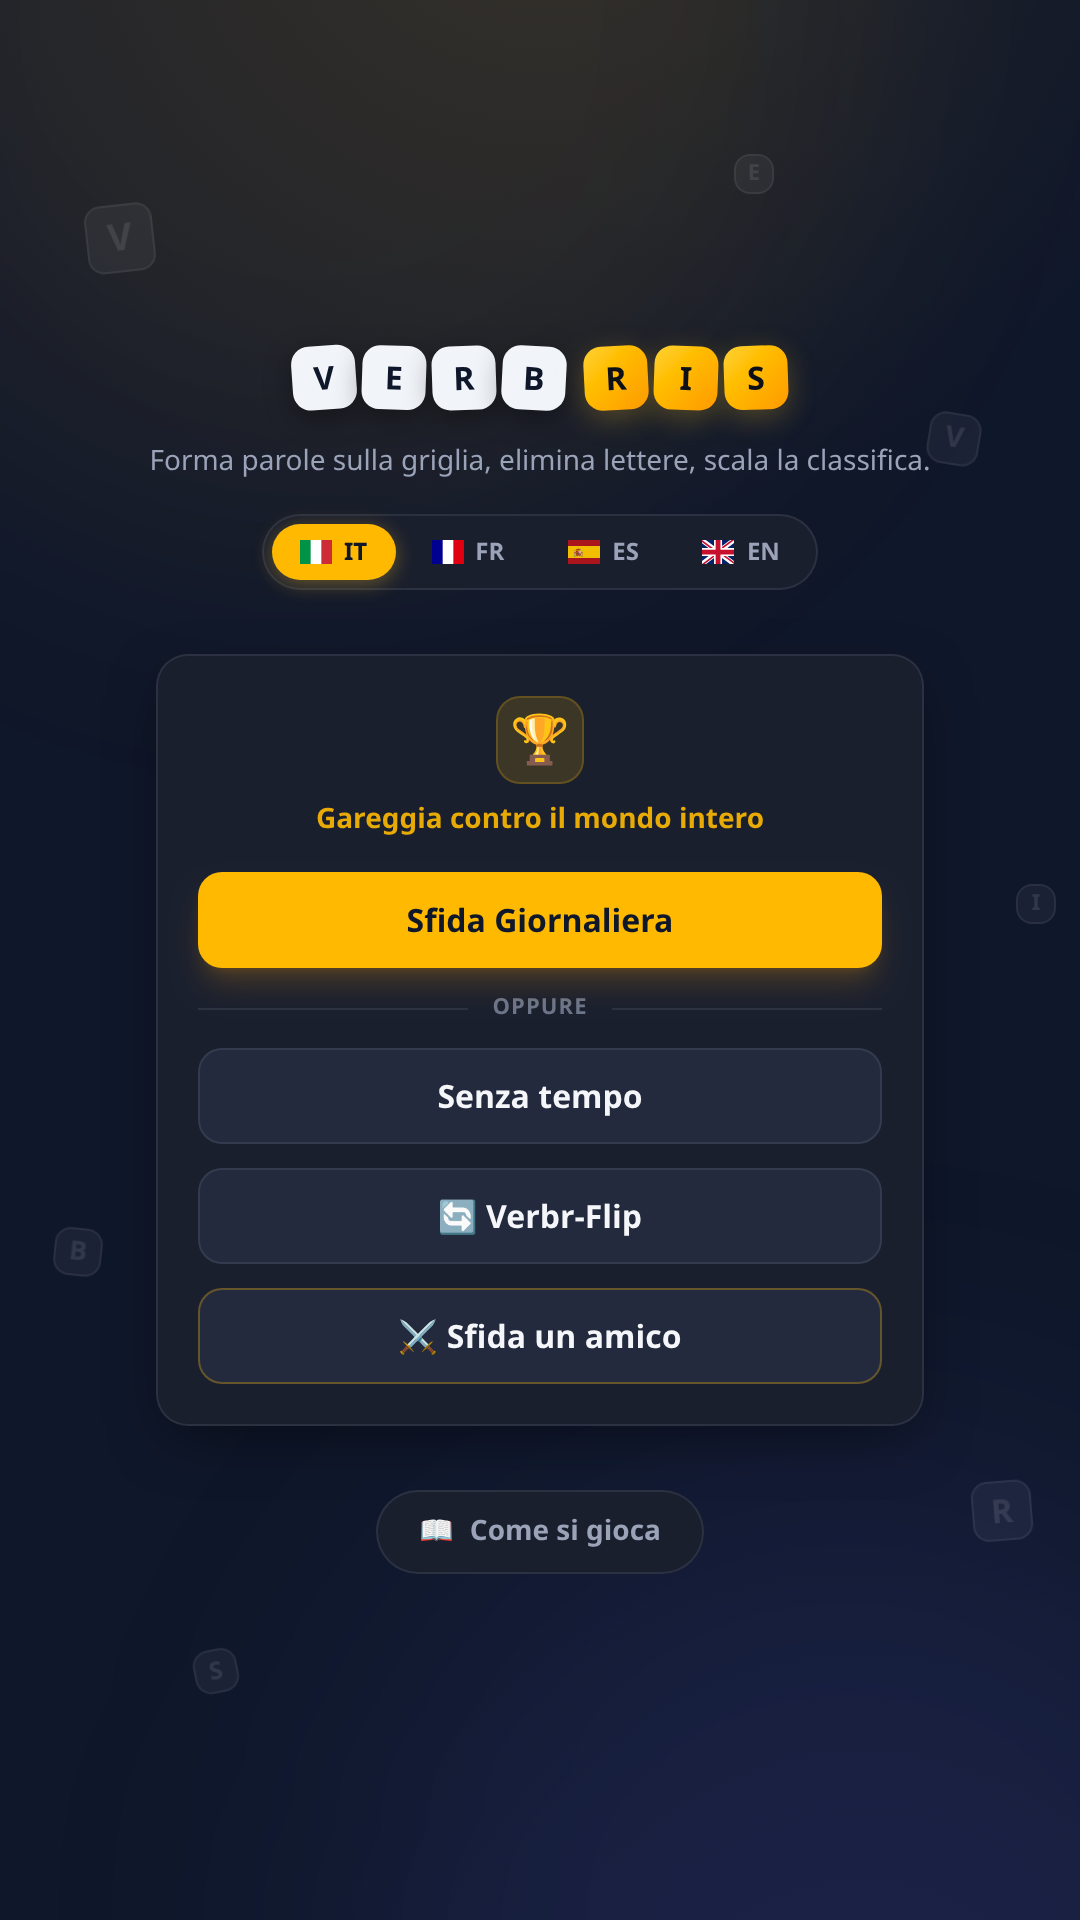 La home rebrandizzata Verbris, con le modalità come voci di menu, agosto 2026.
Cruciverbris, la modalità che si è quasi rinominata da sola
Il nome pubblico è Cruciverbris, da cruciverba più verbum, ma nel codice resta definition* ovunque: lo store definitionRun, la tabella definition_puzzles, l’endpoint /puzzle/daily-definitions. Non è una dimenticanza, è deliberato. Il nome commerciale può ancora cambiare, e rinominare gli identificatori interni per un nome che fra un mese cambierebbe di nuovo è lavoro da fare due volte.
La meccanica non somiglia a nessuna altra modalità. Non c’è il timer che corre e non c’è una griglia intera da esplorare a caso: si svuota risolvendo una catena di indizi, una parola per volta, ognuna conseguenza logica della precedente. Costruire quelle catene è il pezzo tecnico più insolito di agosto, perché per una giornata a tema il processo si inverte. Non parti dalla griglia per vedere quali parole ci stanno: parti dalla catena, dieci indizi legati al mare per dire, e costruisci la griglia a ritroso perché ospiti esattamente quella sequenza, nell’ordine giusto.
Il costo vero però non è nel codice, è nel contenuto: circa 2600 indizi scritti a mano in quattro lingue, organizzati in 204 liste tematiche, che coprono agosto e settembre 2026 per intero. Agosto ha dieci giornate generiche e ventuno a tema, settembre è a tema dal primo giorno. Gli indizi si possono generare con l’IA, con uno script che chiede una definizione per parola in stile cruciverba senza mai usare la parola stessa o la sua radice, oppure scriverli a mano in un file di testo e farli entrare dalla stessa pipeline. Dipendere sempre da una chiave API per produrre testo che si può scrivere direttamente sarebbe un collo di bottiglia senza motivo.
Una scelta di rilascio, non di codice: la voce compare in home da sola, lingua per lingua, solo quando per quella lingua esiste almeno una giornata pubblicata. Niente flag da girare a mano e niente “presto disponibile” da nascondere dopo.
Il percentile invece della classifica
Il 14 agosto arriva l’ultimo pezzo del niente identità. Non solo rinunciare alla classifica mondiale, decisa il 6 luglio, ma dare comunque un confronto: hai battuto l’83% delle partite di oggi, senza che nessuno sappia chi ha fatto quanto.
La via ovvia era una tabella con una riga per partita, punteggio e orario, e un conteggio di quante righe stanno sotto la mia per ricavare la posizione. Funziona, e cresce linearmente con le partite giocate: su una giornaliera con migliaia di run al giorno, ogni fine partita interrogherebbe una tabella che non smette mai di crescere.
La scelta fatta è un istogramma. Quattrocento fasce da cento punti, un contatore per fascia, una riga per puzzle, cioè una al giorno per lingua, circa 1,6 kB che non cresce mai col numero di giocatori. Registrare un punteggio è incrementare la fascia giusta con una funzione SQL atomica, calcolare un percentile è sommare i contatori delle fasce sotto la propria. Il database non sa più che qualcuno ha fatto 1200 punti alle 14:32: sa che quel giorno, in quella fascia, ci sono N partite. Per un rituale quotidiano e non per una classifica competitiva è uno scambio giusto, perché la granularità che si perde non l’avrebbe mostrata nessuna schermata.
Un audit dedicato, il 16 agosto, ha trovato un difetto vero e non ipotetico: la regola che porta dal punteggio alla fascia era scritta due volte, una in SQL e una in TypeScript. È la stessa trappola dell’invariante fra client e server, applicata alla coppia database e servizio. Cambiare il numero di fasce da un lato solo avrebbe fatto dire numeri diversi al fine partita e allo storico, senza che un test diventasse rosso. La correzione ha spostato anche il calcolo in SQL, chiamato da chi scrive, da chi legge e dalla semina, così oggi la regola vive in un posto solo.
E come per la classifica, anche qui la scelta è dichiarata e non nascosta: una rigiocata conta come una partita nuova nell’istogramma. L’ho misurato, il proprio percentile sale senza migliorare, dal 50 al 58% dopo quattro tentativi peggiori su una giornata appena seminata. Il giorno dell’audit ho deciso di accettarlo. Risolverlo vorrebbe dire sottrarre lato client le proprie partite del giorno, cioè fidarsi del client su un numero pubblico, che è esattamente la scorciatoia per cui esiste il replay lato server.
Sapere quanti giocano senza sapere chi
Il 24 agosto la stessa regola arriva anche al conteggio d’uso. Verbris non ha Google Analytics, non ha cookie e non ha un banner di consenso, e non perché i numeri non li guardi nessuno: il modo in cui li guardo è costruito per non poter identificare nessuno nemmeno volendo.
Il principio è quello del percentile applicato a un’altra domanda, quante persone diverse hanno giocato oggi. Ogni evento, inizio e fine di ogni partita per tutte le modalità con un solo punto di aggancio per lato nello store, genera un hash da IP, user agent e un sale che cambia ogni giorno. Il sale non è una tabella da ruotare a mano: si calcola al volo da un segreto fisso più la data di oggi, quindi a mezzanotte cambia da sé. Lo stesso visitatore nello stesso giorno produce sempre lo stesso hash, che basta per contare quanti distinti; il giorno dopo il sale è diverso e quell’hash non è più ricostruibile, quindi seguire la stessa persona da un giorno all’altro non si può, perché la funzione non si inverte.
Le uniche righe che portano qualcosa derivato da un dato personale si buttano dopo otto giorni, a ogni esecuzione dello script che stampa il report. Il resto, quante partite per modalità e per lingua, è un contatore puro: nessuna colonna può contenere un’identità.
Lo scrivo qui e non in un changelog perché è la terza volta che la stessa domanda, posso avere questo numero senza un’identità sotto, riceve una risposta tecnica diversa per un problema diverso. Prima il punteggio, con l’istogramma. Poi i giocatori, con l’hash a vita breve. Non è un principio scritto una volta e ricopiato: è una domanda che mi sono rifatto ogni volta che serviva un numero collettivo, e per ora la risposta è sempre stata sì.
Il popup di fine partita
Se c’è un pezzo di interfaccia che racconta da solo come si è mosso il progetto è questo. Il 16 giugno, tolta la conferma d’uscita, arriva un redesign delle statistiche con tendine per navigare fra le viste, grafici delle ultime otto giornate e percentile storico. Qui la direzione è opposta a quella delle rimozioni: non togliere attrito, ma dare contesto. “Hai fatto 120 punti” da solo non dice niente.
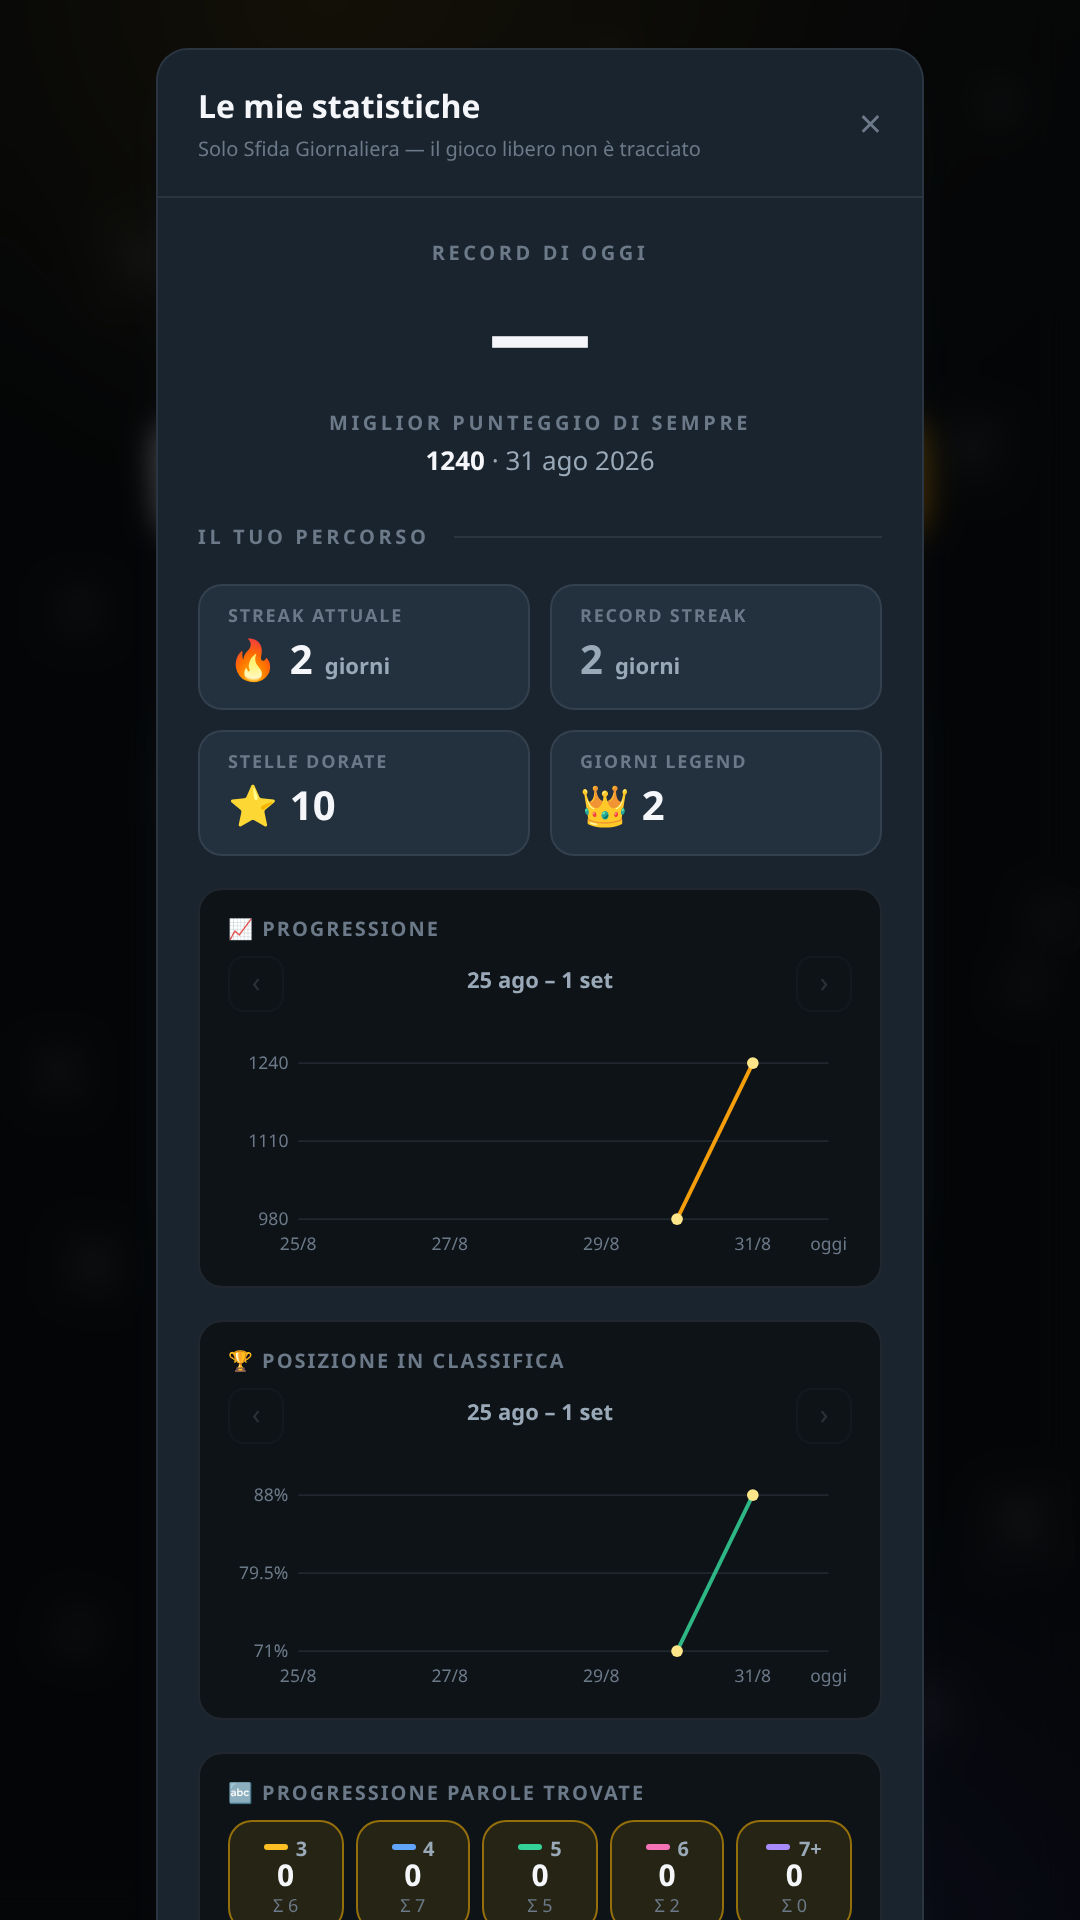 Il popup statistiche oggi: streak, stelle, giorni Legend e due grafici. È la stessa idea del 16 giugno, rifinita.
L’ultima aggiunta è di inizio settembre: una celebrazione visiva che cresce insieme al percentile, più festosa man mano che sali. Ho scelto di non mettere una soglia minima di partite prima di mostrarla, pur sapendo che nelle prime ore della giornata il campione è piccolo e il numero può essere generoso. Preferisco che chi gioca alle sette del mattino veda la festa, e che il numero si assesti da solo durante la giornata.
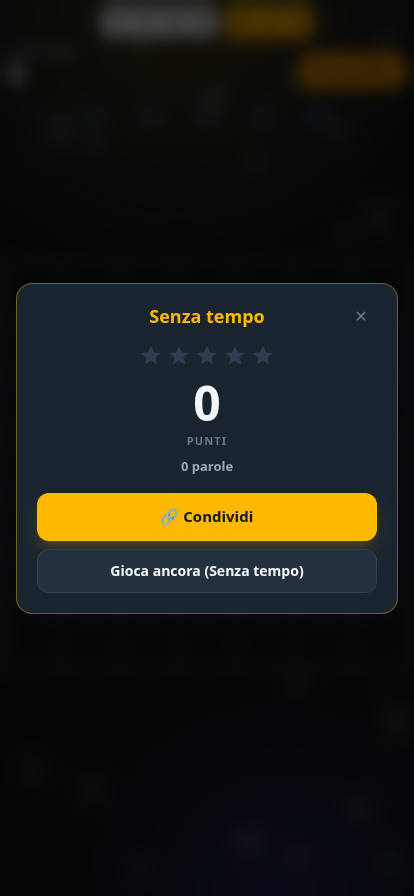 Il riepilogo di fine partita oggi, qui in Senza tempo e catturato senza completare parole, per questo il punteggio è a zero. Nella Sfida Giornaliera lo stesso componente mostra anche il percentile.
Le clip promozionali, un browser headless che gioca per davvero
Il 17 agosto parto dalla via ovvia per chi ha già un bot che gioca da sé, lo stesso che calcola il par per le stelle: fargli giocare centinaia di partite, scegliere le migliori con criteri misurabili come la cascata più lunga, il punteggio più alto o la parola più rara, e montarle con ffmpeg in tre formati, con countdown e reveal disegnati sopra fotogrammi congelati. Ha funzionato, è andata in produzione, ed è la pipeline che ho poi buttato via: si vedeva che il gioco non lo stava giocando nessuno.
Il sostituto, di fine agosto, è più facile da descrivere e più difficile da ottenere. Si registra una vera istanza del gioco mentre gioca, con Chrome headless pilotato da Playwright. Quello che lo rende possibile senza inventare endpoint finti nel backend né portare codice di regia nel bundle è intercettare la richiesta di rete con cui il client carica la giornaliera, e rispondere con un puzzle del pool Senza tempo invece di quello vero del giorno. L’app crede di giocare una daily normale, con il timer che scorre, mosse vere e uscita di scena vera, e non sa di essere in uno studio di posa. Il backend reale non viene mai contattato, quindi la regola “mai la daily di oggi o di domani” per non fare spoiler è garantita dal fatto che il video non la può vedere, non da una lista di controlli da ricordare.
Il timer merita una nota, perché è il dettaglio più facile da sbagliare: nasce a 35 secondi invece di 15 per lasciare margine ai tap durante la registrazione, e appena finita l’ultima mossa viene forzato a zero. Il conto alla rovescia che si vede nel video finito è retrodatato di proposito, non è mai stato il tempo vero.
La parte meno ovvia è come si catturano i fotogrammi. La strada tecnicamente più pulita era la funzione nativa di Chrome per questo scopo, Page.startScreencast del protocollo di debug, quella che gli strumenti di sviluppo usano per mostrare lo schermo del telefono emulato: ogni fotogramma arriva con il proprio istante, quindi mappare una mossa su un secondo è immediato. Misurando invece di supporre è venuto fuori che quella funzione ignora la densità di pixel del dispositivo simulato e cattura sempre alla risoluzione CSS del viewport, 390 pixel di larghezza, non a quella vera del telefono da imitare, che è il triplo. È un limite di Chromium, verificato anche forzando a mano i comandi di basso livello del protocollo, non un’opzione da passare meglio.
Il 18 agosto ho provato l’alternativa ovvia: catturare un fotogramma per volta con lo screenshot normale della pagina, che quella densità la rispetta. Funzionava, ma costava quasi mezzo secondo per fotogramma, e su una registrazione vera il frame rate è crollato da 59 a 4. Troppo poco fluido per un feed in cui si scorre in un secondo, e ho annullato quel cambiamento due minuti dopo averlo committato. È il tipo di marcia indietro che scrivendo a mano costerebbe l’orgoglio di disfare ore di lavoro, e che con un’IA che riscrive in minuti è solo la mossa giusta.
La soluzione accettata, dieci giorni dopo e ancora una volta misurando, non risolve il limite: lo compensa. I fotogrammi restano alla risoluzione bassa che Chromium impone, e l’ingrandimento fino alla risoluzione finale del video, quasi il triplo, usa Lanczos invece del filtro bilineare di default di ffmpeg. Più nitido a parità di sorgente, senza inventare dettaglio che nel fotogramma non c’è. Non è la soluzione elegante che avrei voluto raccontare, è quella vera, con il limite dichiarato invece di nascosto in un commento ottimista.
L’ultima astuzia riguarda la variante dei video in cui tre o quattro parole vengono scelte una lettera alla volta col tap invece che trascinate, seguite da un tentativo sbagliato ripetuto apposta prima che il tempo scada. Quelle sequenze non sono scritte a mano: uno script offline rigioca ogni mossa con lo stesso motore che il server usa per il replay, processMove, quindi sa dove sarà ogni lettera dopo che gravità e riserva hanno cambiato la griglia, e lo fa con lo stesso seed che userà il client durante la registrazione. Il percorso di tap sembra deciso lì per lì e invece è pre-calcolato esattamente come lo vedrà il motore vero, comprese le parole sbagliate: percorsi veri sulla griglia che il gioco rifiuta per davvero, non tasti premuti a caso vestiti da errore.
I video escono pronti per YouTube, Instagram e TikTok, con i testi presi da un insieme di varianti per non ripetere la stessa didascalia due volte di fila, e con una delle quattro uscite di scena della griglia scelta a caso, la stessa che vede chi gioca.
Un baco vero: lo sfondo che rallentava tutto
Il 28 agosto arriva una segnalazione secca: il gioco rallenta, sia trascinando le lettere sia durante la cascata dopo una parola. La prima ipotesi, componenti React che si ridisegnano più del necessario, era vera ma non bastava. Ho sistemato quattro componenti che si abbonavano all’intero stato del gioco invece dei singoli campi che usavano davvero, perché un timer che aggiorna quattro volte al secondo faceva ridisegnare pannelli che il tempo non lo mostrano nemmeno, e il gioco era ancora lento.
La misura che ha trovato la causa non ha contato i render, ha contato i fotogrammi. Da fermi, senza toccare niente, la schermata di gioco girava a 25 fotogrammi al secondo invece di 60. Il collo di bottiglia non era l’interazione: era qualcosa che consumava CPU in continuazione, su ogni schermata, anche dietro un modale chiuso.
Era lo sfondo decorativo, due bagliori semitrasparenti che fluttuano lentamente dietro ogni schermata, con una sfocatura da 70 pixel applicata sopra un elemento animato. Uno spostamento o uno zoom li calcola la GPU quasi gratis, componendo layer già pronti; una sfocatura di quella grandezza, animata, costringe il browser a ri-sfocare l’intera area a ogni fotogramma invece di farlo una volta sola. Tolta la sfocatura e sostituita con una sfumatura che si dissolve verso il trasparente, con lo stesso effetto a schermo, si torna a 60 fotogrammi da fermi, da 21 a 52 durante un trascinamento vero e da 23 a 55 durante una cascata dopo una parola accettata.
Quello che mi ha insegnato qualcosa non è la correzione, è dov’era il baco. Cercavo la lentezza nel codice che reagisce al gesto di chi gioca, la selezione, la validazione, la caduta delle lettere, e il colpevole non reagiva a niente: girava sempre, sotto tutto, da quando l’app si apre. Da allora, quando qualcosa sembra lento durante X, la prima domanda che mi faccio non è cosa fa X di sbagliato, è cosa gira anche quando X non lo sto facendo.
Verbris oggi
Tre mesi e 828 commit dopo il primo, lo stato attuale. Il tema scuro è quello di default dall’inizio, e non l’avevo più mostrato da vicino dopo il redesign di giugno.
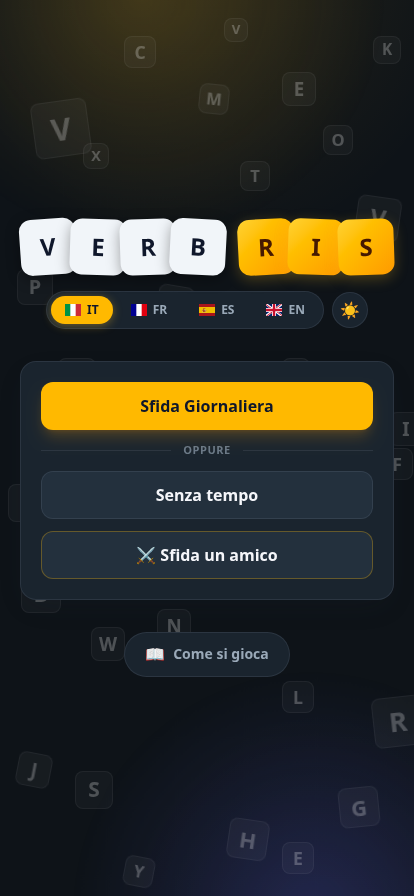 La home oggi: le modalità come voci di menu, tema scuro.
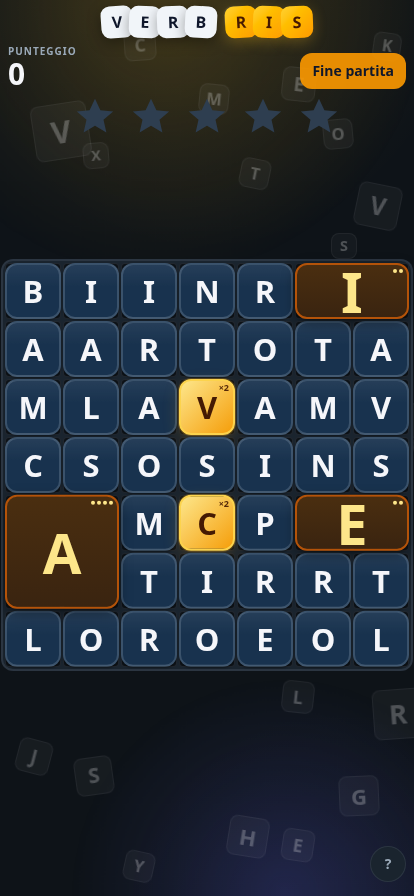 La griglia di gioco oggi.
Il tema chiaro
Ultima evoluzione visiva, presente da agosto: un tema chiaro completo. Non un filtro sopra i colori esistenti, ma sfondo, tessere, pannelli e stati ridisegnati per entrambi i temi.
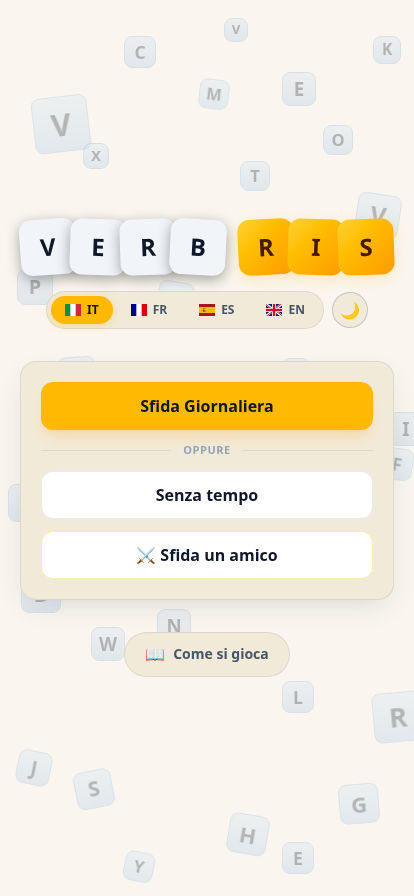 La stessa home di oggi, in tema chiaro.
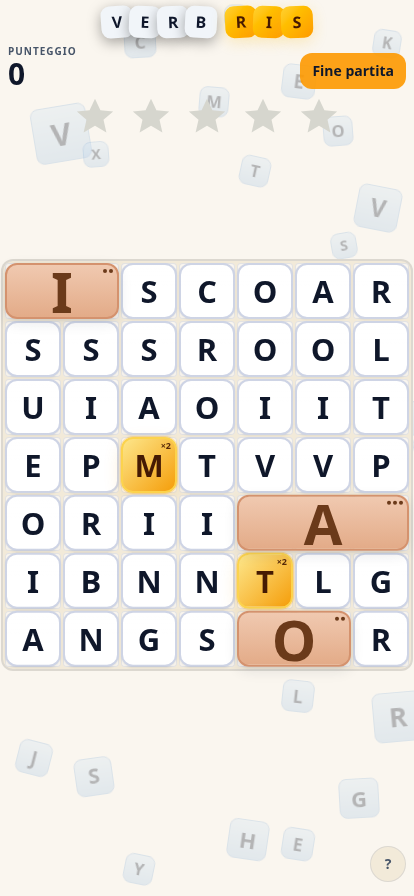 La griglia di gioco in tema chiaro.
I numeri
- 828 commit dal 4 giugno al 2 settembre 2026, nessuno scritto a mano.
- 459 a giugno, 335 ad agosto. Luglio è il mese con meno commit e con le decisioni più pesanti.
- 45 specifiche, 45 piani, 16 audit del codice.
- Una ventina di commit che rimuovono o annullano qualcosa di già costruito.
- 5 modalità di gioco sullo stesso motore, in italiano, francese, spagnolo e inglese.
- Circa 2600 indizi scritti a mano per Cruciverbris e 204 liste tematiche.
- 463 test sul frontend, 16 sul backend, più la rete di non regressione del generatore.
Tre mesi dopo
L’IA non l’ho usata per scrivere codice più in fretta di quanto lo scriverei io. L’ho usata per potermi permettere di cambiare idea. Costruire login, amici e classifica a giugno e buttarli ad agosto, scrivendo ogni riga a mano, sarebbero state settimane bruciate su una scommessa di prodotto: nella pratica non lo avrei fatto, avrei tenuto tutto e avrei chiamato “roadmap” il fatto di non saper decidere. Quando una specifica diventa codice in poche ore quel calcolo cambia, e il vincolo si sposta altrove: non è più quanto in fretta scrivi, è quanto sei disciplinato nel decidere cosa tenere. Le 45 specifiche e i 16 audit servono a quello.
L’architettura di fondo, codice condiviso fra client e server, determinismo, modalità come dati, non l’ho mai dovuta riscrivere. Tutto il resto sì: il nome, l’autenticazione, il modello di punteggio, l’interfaccia quattro volte. Per questo “un mese” nel titolo non è una trovata: è il tempo che ci è voluto per avere un motore abbastanza solido da reggerci sopra altri due mesi di ripensamenti.