Travail · 2026
Verbris : comment j'ai créé un jeu en un mois avec l'IA
828 commits entre le 4 juin et le 2 septembre 2026, aucun écrit à la main. Comment est né Verbris, un jeu de navigateur à mi-chemin entre Ruzzle et Tetris, et tout ce que j'ai construit puis supprimé.
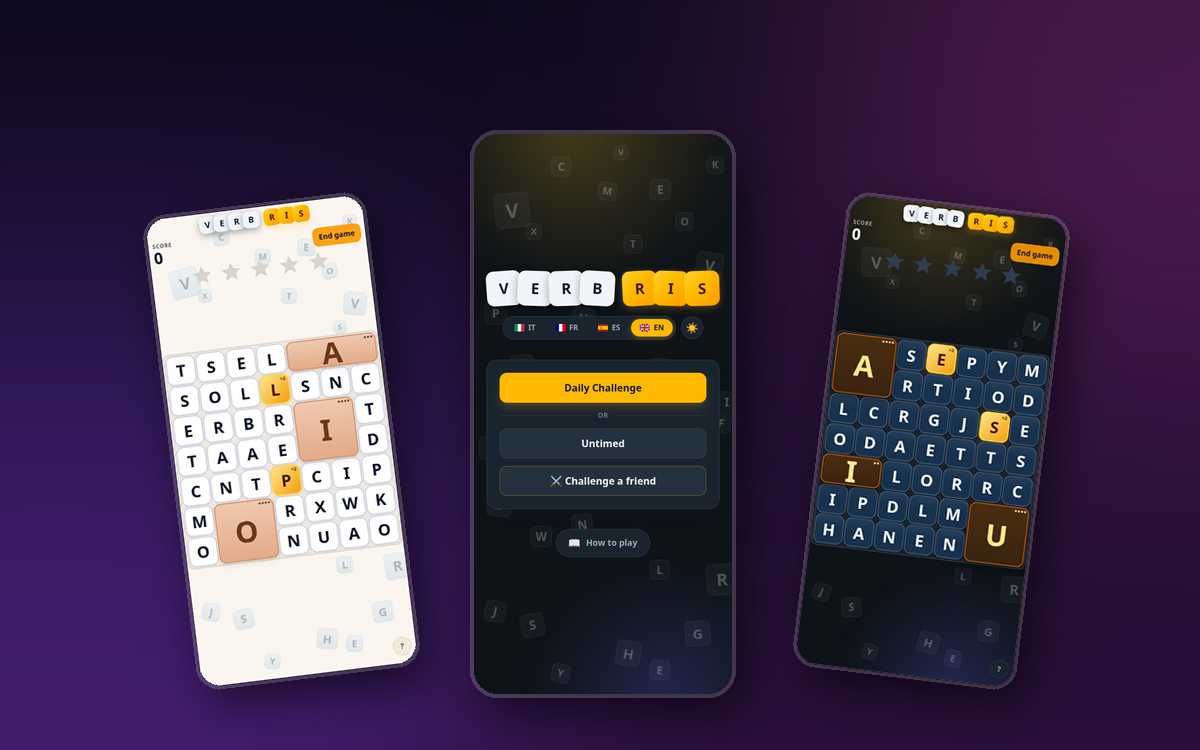
Les dates citées ici sont celles des commits : 828, du 4 juin au 2 septembre 2026. Les images ne sont pas des maquettes. J’ai fait tourner le code tel qu’il était à chaque étape et j’ai capturé l’écran. Les captures sont celles de la version anglaise du jeu.
Le point de départ
Le 4 juin 2026, j’ouvre un éditeur et je commence Verbris, un jeu de navigateur à mi-chemin entre Ruzzle et Tetris. De Ruzzle il reprend les mots tracés sur des lettres adjacentes ; de Tetris, la gravité : un mot validé disparaît et les lettres du dessus tombent, tandis qu’une grille de réserve cachée réapprovisionne par le haut. Deux jours plus tard, il était réellement en ligne, déployé sur Vercel et Railway.
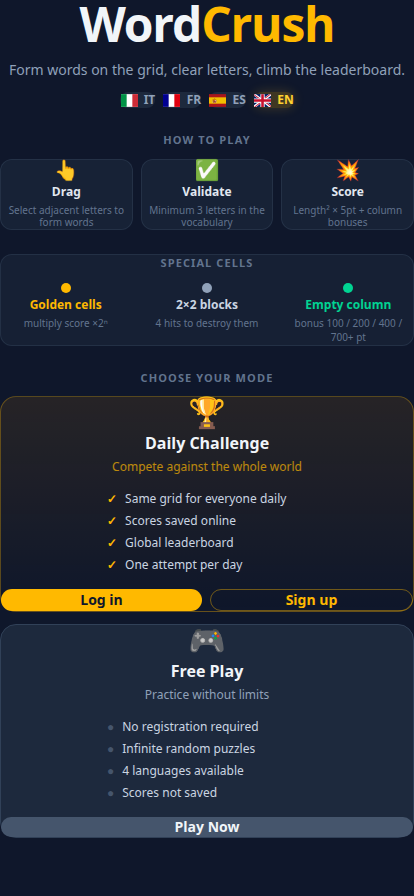 La toute première version publiée. Le jeu s’appelait encore WordCrush et l’on jouait en faisant glisser le doigt sur les lettres.
Le titre dit « un mois » parce que juin a suffi : à la fin du mois, le jeu avait des comptes, des statistiques, des classements, un générateur de grilles en quatre langues et un serveur qui, plutôt que de faire confiance au score qu’il reçoit, rejoue la partie pour la vérifier. Ce qui s’est passé à partir de juillet relevait d’un autre travail : décider ce qui, de ce premier mois, méritait de rester. C’est cette partie-là qui me semble valoir d’être racontée.
Je n’ai pas écrit une seule ligne de code. Les 828 commits sont tous sortis d’un agent IA, Claude Code, que j’ai piloté, dont j’ai lu les diffs et à qui j’ai renvoyé le travail quand il ne me convainquait pas. Je ne lui ai jamais demandé de « me faire un jeu » : j’ai demandé une spec à la fois. Je commence par la méthode parce que sans elle les chiffres qui suivent ne veulent pas dire grand-chose.
La méthode : la même boucle, quarante-cinq fois
Le dépôt contient 45 documents de spécification, 45 plans d’implémentation et 16 audits de code, écrits avant ou juste après le code qu’ils décrivent. La boucle est toujours celle-ci :
- Une spec en langage clair : ce qui doit se passer et pourquoi, avant d’ouvrir un fichier. Par exemple
2026-06-12-daily-session-anticheat-design.md,2026-07-06-modello-rituale-design.md. - Un plan qui découpe la spec en étapes, en listant les fichiers concernés.
- L’implémentation, écrite par l’IA et relue par moi, diff par diff.
- De temps en temps un audit : une passe consacrée uniquement à traquer le code mort, les doublons et la complication inutile. Le dernier date du 30 août.
- La vérification, qui n’est pas « ça a l’air de marcher » : 463 tests côté frontend, 16 côté backend, type-check, lint, et pour le générateur de grilles un contrôle de non-régression (
pnpm gen:golden) qui doit rester vert avec une empreinte inchangée.
Sautez la spec et une IA vous écrit quand même le code, et vite. Le problème apparaît trois semaines plus tard, quand ce code fonctionne toujours mais que plus personne, vous compris, ne sait dire pourquoi une règle est écrite comme ça. La conversation qui l’a produite est fermée depuis longtemps. La spec, elle, reste.
Juin, les 459 commits fondateurs
Le premier vrai problème arrive au bout de trois jours : glisser à la souris est pénible sur un écran de téléphone. Le 7 juin, le jeu passe au tap-to-play et la page d’accueil est redessinée. À partir de là, il cesse d’être une expérience de bureau.
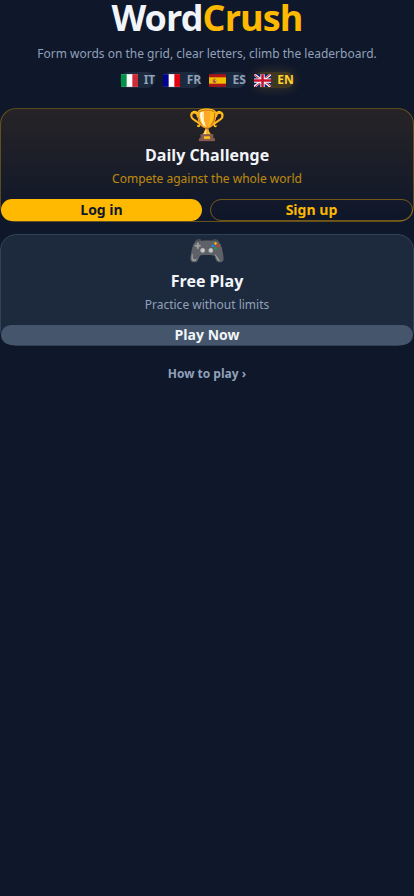 Après le tap-to-play : une mise en page resserrée, le « Comment jouer » déplacé dans un panneau au lieu d’occuper une place fixe.
Puis le mois s’emballe. Arrivent les statistiques du joueur, les classements mondiaux, les amis, l’authentification, un écran de fin de partie de plus en plus élaboré, des effets sonores génératifs. Le 18 juin, refonte complète de l’interface : des design tokens déclarés une seule fois avec le @theme de Tailwind, des cellules avec davantage d’états visuels, un chronomètre à barre plutôt qu’en texte brut, un onboarding contextuel qui ne bloque pas le jeu.
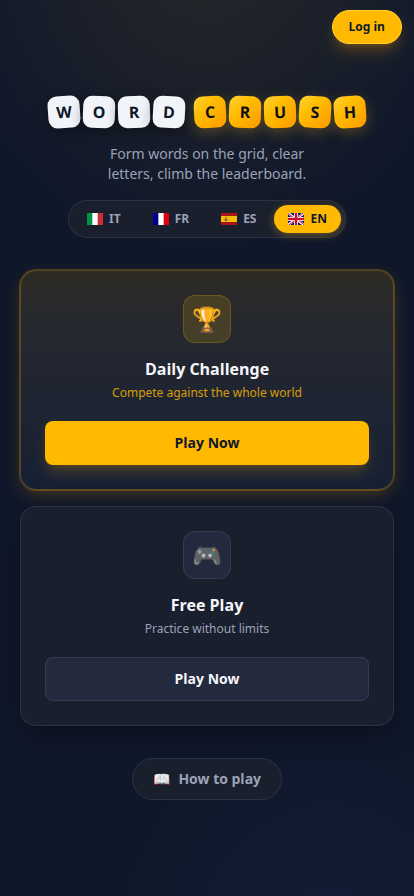 La refonte du 18 juin. Le nom est encore WordCrush et il y a encore un bouton « Se connecter » en haut à droite.
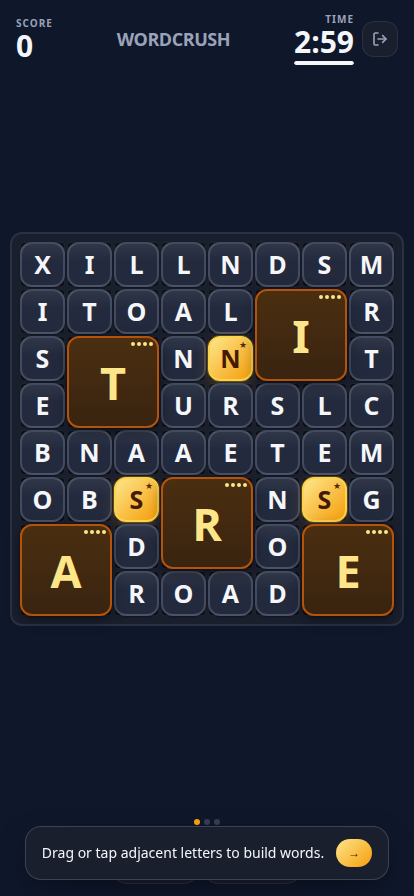 La grille à la même période : chronomètre à barre colorée, blocs 2×2, cellules dorées, onboarding encore superposé.
Sous la surface, pourtant, le commit qui compte plus que n’importe quelle refonte est celui du 20 juin : un replayRun partagé. À partir de là, le serveur cesse de calculer le score à sa manière : il rejoue les coups qu’il reçoit avec le même moteur que le client, et si le résultat ne correspond pas, il jette la partie. Client et serveur exécutent le même code, pas deux implémentations parallèles de la même règle. Cela gouverne chaque fonctionnalité depuis.
Le 30 juin, un mois jour pour jour après le lancement, le jeu change de nom. WordCrush devient Verbris et déménage sur un nouveau domaine. Renommer un produit déjà en ligne avec de vrais joueurs coûte quelque chose : les liens partagés cassent, l’indexation est à refaire, la reconnaissance repart de zéro. Je l’ai fait parce que WordCrush sonnait comme le clone de quelque chose d’autre, alors que Verbris (de verbum) portait l’identité multilingue vers laquelle le jeu grandissait.
Ce que j’ai construit puis supprimé
Les études de cas omettent généralement cette partie, et c’est à mon sens celle qui apprend le plus quand on travaille avec une IA qui écrit du code à cette vitesse. Sans elle, chaque décision a l’air juste du premier coup, ce qui n’est pas ce qui s’est passé.
Connexion, amis et classement mondial : juin, puis supprimés le 15 août
En juin, le jeu avait des comptes, de l’authentification, des invitations entre amis et un classement mondial.
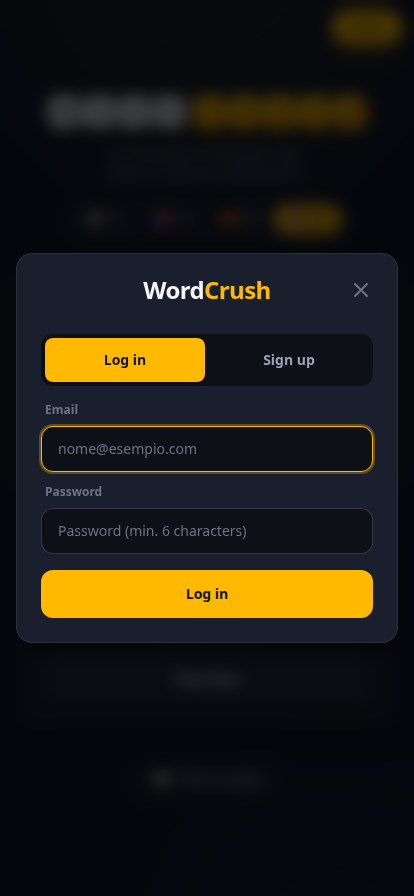 La fenêtre de connexion et d’inscription. Elle est inaccessible aujourd’hui : le code derrière a été supprimé, pas seulement masqué.
Le 6 juillet, un mois après l’avoir construit, j’ai décidé de renoncer au classement mondial et à l’identité persistante. La raison est technique. Un classement mondial sérieux exige un anti-triche solide, sinon il suffit de changer d’appareil ou de vider le cache pour y pousser un score inventé. Cet anti-triche représentait des semaines de travail, et il existait pour transformer un rituel quotidien de trois minutes en compétition. Je ne voulais pas que Verbris soit cela.
Cinq semaines plus tard, le 15 août, j’ai fait ce qu’on remet d’habitude à plus tard : au lieu de cacher connexion, amis et classement derrière un drapeau, je les ai supprimés du code. Environ 1 300 lignes, parties. Les garder « pour plus tard, on ne sait jamais » est la façon la plus courante d’accumuler du code mort auquel plus personne n’ose toucher.
Le classement première tentative, qui a duré une soirée
Le 6 juillet toujours, avant d’arriver au modèle final (votre meilleur score compte, les reprises sont illimitées), j’avais fait implémenter l’alternative apparemment plus juste : seule la première tentative du jour compte, et qui veut rejouer le fait dans un mode Entraînement séparé. Je l’ai regardé fonctionner et je l’ai jeté le soir même. Sans identité vérifiée, « seule la première tentative compte » se contourne comme n’importe quel classement : en changeant d’appareil. Cela ajoutait de la friction pour les gens qui jouent honnêtement sans arrêter les autres.
Le classement mondial, cinq jours en vie
Le 10 juin, l’écran de fin de partie gagne un sélecteur Officiel/Meilleur pour se comparer aux scores mondiaux. Le 15 juin, avec le passage au « votre meilleur compte », cette comparaison ne voulait plus rien dire, et mélanger tentatives officielles et libres dans un même classement n’était que source de confusion. Exit le sélecteur, et exit le store leaderboard qui l’alimentait.
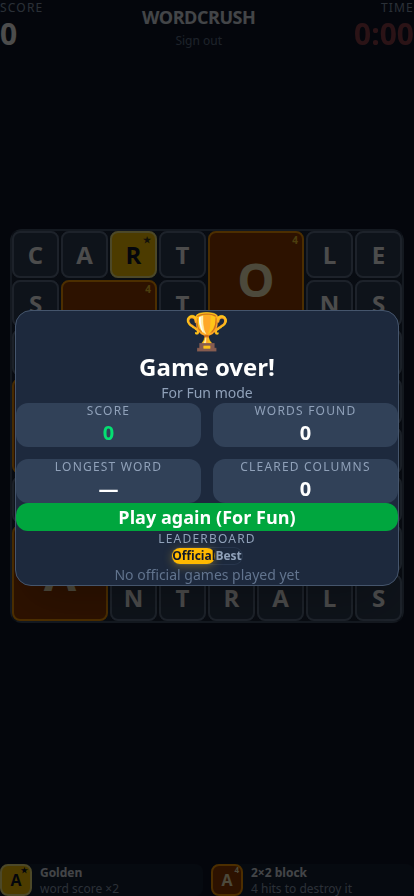 L’écran de fin de partie du 10 juin avec le sélecteur de classement mondial : construit le 10, retiré le 15.
La fenêtre de confirmation de sortie, trois jours
Le 12 juin, je fais construire l’anti-triche de la partie quotidienne, avec une fenêtre temporelle côté serveur et une confirmation avant de quitter en cours de partie (quitter valait soumission partielle). Je la retire le 15 en même temps que la soumission partielle : le modèle était devenu « votre meilleur compte », donc partir en cours de route ne faisait plus rien perdre et cette confirmation n’était qu’un obstacle. Un élément d’interface parfaitement sensé le lundi devient une gêne le jeudi, si l’on change le modèle en dessous.
Les vidéos promo avec le bot
En août, j’ai fait construire un pipeline qui générait des clips promotionnels à partir des coups d’un bot, en trois variantes (quiz, community, playout). Ils sont restés un moment en production, puis je les ai retirés. Le clip qui filme la vraie application, avec un chronomètre qui tourne et un coup réel, fonctionnait mieux qu’un bot qui fait semblant de jouer.
Le défi par lien, un multijoueur anonyme né le même jour
Le 6 juillet n’a pas servi qu’à retirer des choses. Le jour même où je jette le classement mondial, je construis ce qui le remplace pour l’usage qui comptait vraiment : défier des amis plutôt que le monde entier. Vous créez un défi, vous envoyez une URL, et celui qui l’ouvre joue exactement la même grille et atterrit dans un petit classement. Personne ne sait qui sont les joueurs, le serveur compris.
L’identité est un jeton que le serveur génère au premier contact et que le client conserve dans localStorage. Ce n’est pas un compte, juste un moyen de reconnaître qu’il s’agit du même appareil que lors du défi précédent. Si le jeton manque ou n’est plus valide, le serveur en délivre un autre sans rien demander.
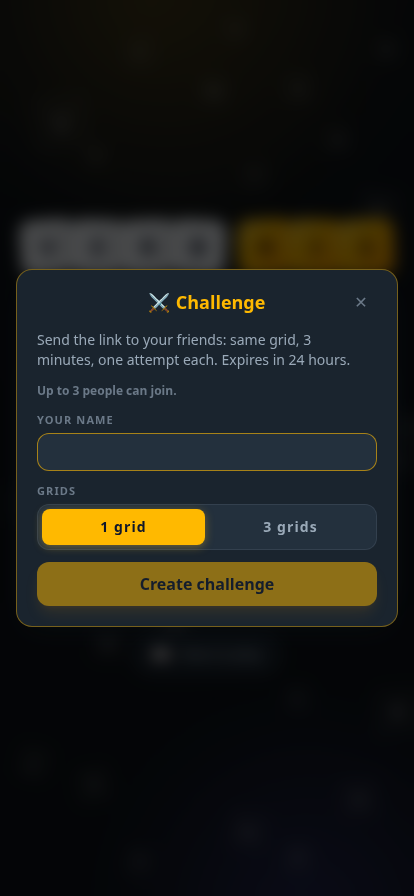 La fenêtre de défi aujourd’hui : pseudo, nombre de grilles, et la limite produit annoncée clairement, trois joueurs.
Le score passe par le même moteur que la partie quotidienne : le client envoie les coups plutôt que le total, et le serveur les rejoue avec replayRun. Il n’existe pas de version plus permissive pour les défis. Le déterminisme suit la même route : les cellules dorées renaissent d’une graine calculée dans game-core avec la formule de la quotidienne, si bien que tout le monde voit la grille évoluer à l’identique.
Il existe toutefois ici une attaque que la quotidienne ne connaît pas : ouvrir le lien, étudier la grille à loisir sans chronomètre, et ne commencer à jouer qu’ensuite en déclarant un temps faux. La défense est un marqueur. Le serveur consomme la grille — c’est-à-dire enregistre que cette partie a commencé et n’a pas encore été soumise — à l’instant où le client la demande pour jouer, et non quand il l’affiche. Une fenêtre temporelle fixe démarre à ce moment-là, et abandonner sans soumettre laisse un zéro. Une revue consacrée au mode, le 16 août, a trouvé que dans la première version la requête publique servant à afficher le classement et le compte à rebours renvoyait quand même la grille complète, rouvrant la fenêtre d’étude que le marqueur devait fermer. Corrigé en déplaçant cette partie de la réponse dans la seule requête qui consomme effectivement le marqueur.
Une précision que je dois au lecteur : chaque défi accueille jusqu’à trois joueurs. C’est une limite produit, pas technique, car la table des scores comporte une ligne par joueur et par défi et n’a aucune raison structurelle de s’arrêter là. Défier un ami visait un petit groupe qui se connaît, pas un tournoi public — lequel aurait exigé le même anti-triche qui m’a fait abandonner le classement mondial quelques paragraphes plus haut.
Les deux règles auxquelles je n’ai plus jamais touché
Deux contraintes sont devenues assez intouchables pour avoir leur propre section dans le guide que l’IA lit au début de chaque session.
La première : client et serveur partagent le code. game-core, le paquet qui décide si un coup est valide et ce qu’il vaut, est importé aussi bien par le frontend que par le backend. Si le client appliquait un bonus que le serveur ignore, le rejeu rejetterait toutes les parties légitimes. La règle vit à un seul endroit et deux appelants l’utilisent.
La seconde : le déterminisme. Un même jour doit produire exactement la même grille pour tout le monde, dans une même langue, et le rejeu du serveur doit consommer la même séquence aléatoire que celle vue par le client. Le générateur pseudo-aléatoire à graine vit dans un seul module, il n’y a pas un seul Math.random() sur les chemins qui comptent, et même le générateur hors ligne ne regarde jamais l’horloge.
Une troisième règle est arrivée plus tard, née d’un vrai bug : en août, l’état de Cruciverbris survivait à l’intérieur de la quotidienne classique, qui se retrouvait à porter des indices et des règles qui n’étaient pas les siens. D’où le choix de traiter les modes comme de la donnée, avec huit tables Record<GameMode, …> pour les champs, le comportement, les écrans, les menus, les tutoriels et la fin de partie. Ajoutez un mode en oubliant une ligne, et le compilateur TypeScript refuse de compiler. Ce n’est pas de l’élégance : c’est une façon de rendre ce bug impossible une seconde fois.
Cela a plus à voir avec l’IA qu’il n’y paraît. Un agent respecte bien mieux un invariant vérifié par le compilateur qu’une consigne répétée de vive voix à chaque conversation. Un Record<GameMode, …> vaut dix lignes de CLAUDE.md.
Août, 335 commits et quatre langues
Août est le deuxième mois le plus intense, celui où le jeu cesse d’être un casse-tête pour devenir un petit ensemble de modes sur un seul moteur.
Il y a désormais cinq modes. Cruciverbris et le centile de fin de journée ont chacun leur section ci-dessous. Verbr-Flip retourne les lettres au lieu de les faire disparaître, sans gravité : il est complet et testé, mais il reste hors du menu, caché par une seule ligne de code (visible: () => false). Ce n’est pas du travail inachevé, c’est une sortie différée, ce qui est différent des suppressions ci-dessus.
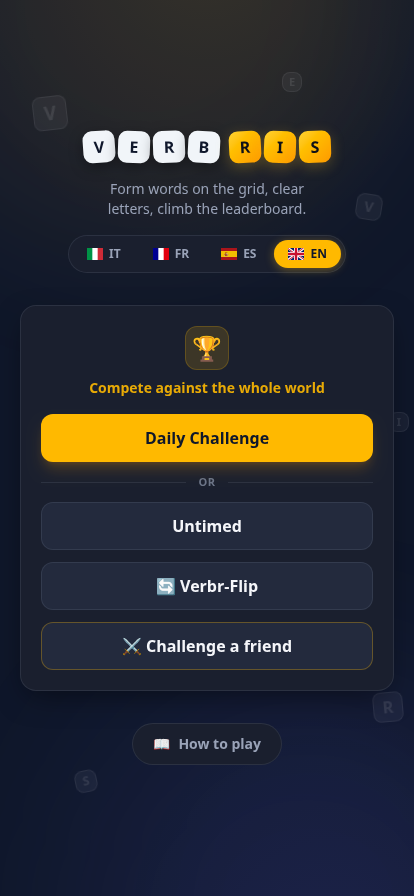 La page d’accueil rebaptisée Verbris, avec les modes en entrées de menu, août 2026.
Cruciverbris, le mode qui a failli se renommer
Le nom public est Cruciverbris, de cruciverba et verbum, mais dans le code il reste definition* partout : le store definitionRun, la table definition_puzzles, l’endpoint /puzzle/daily-definitions. Ce n’est pas un oubli, c’est délibéré. Le nom commercial peut encore changer, et renommer des identifiants internes pour un nom susceptible de changer encore dans un mois, c’est du travail fait deux fois.
La mécanique ne ressemble à aucun autre mode. Pas de chronomètre qui tourne, pas de grille entière à explorer au hasard : elle se vide à mesure qu’on résout une chaîne d’indices, un mot à la fois, chacun conséquence logique du précédent. Construire ces chaînes est la pièce d’ingénierie la plus inhabituelle du mois d’août, car pour une journée thématique le processus s’inverse. On ne part pas de la grille pour voir quels mots rentrent : on part de la chaîne — dix indices sur la mer, par exemple — et on construit la grille à rebours pour qu’elle contienne exactement cette séquence, dans le bon ordre.
Le vrai coût n’est pourtant pas dans le code, il est dans le contenu : environ 2 600 indices écrits à la main en quatre langues, organisés en 204 listes thématiques, couvrant tout août et tout septembre 2026. Août compte dix journées génériques et vingt et une thématiques ; septembre est thématique dès le premier jour. Les indices peuvent être générés par IA, via un script qui demande une définition de mots croisés par mot sans jamais utiliser le mot lui-même ni sa racine, ou écrits à la main dans un fichier texte et passés dans le même pipeline. Dépendre toujours d’une clé d’API pour produire un texte qu’on pourrait taper directement serait un goulot d’étranglement sans raison.
Un choix de publication plutôt que de code : l’entrée apparaît d’elle-même sur la page d’accueil, langue par langue, seulement une fois que cette langue dispose d’au moins une journée publiée. Aucun drapeau à basculer à la main et aucun « bientôt disponible » à masquer ensuite.
Le centile à la place du classement
Le 14 août arrive la dernière pièce du sans-identité. Non seulement renoncer au classement mondial, décidé le 6 juillet, mais proposer quand même une comparaison : vous avez battu 83 % des parties du jour, sans que personne sache qui a fait quel score.
La route évidente était une table avec une ligne par partie, score et horodatage, et un comptage des lignes situées sous la mienne pour en déduire la position. Cela fonctionne, et cela croît linéairement avec les parties jouées : sur une quotidienne à plusieurs milliers de parties, chaque fin de partie interrogerait une table qui ne cesse de grossir.
Ce qui a été construit est un histogramme. Quatre cents paniers de cent points, un compteur par panier, une ligne par grille — c’est-à-dire une par jour et par langue — soit environ 1,6 ko qui ne grossit jamais avec le nombre de joueurs. Enregistrer un score revient à incrémenter le bon panier via une fonction SQL atomique ; calculer un centile revient à sommer les compteurs situés sous le sien. La base ne sait plus que quelqu’un a marqué 1 200 points à 14 h 32 : elle sait que ce jour-là, dans ce panier, il y a N parties. Pour un rituel quotidien plutôt qu’un classement compétitif, l’échange est juste, car la granularité perdue est une granularité qu’aucun écran n’aurait affichée.
Un audit dédié, le 16 août, a trouvé un défaut réel et non hypothétique : la règle associant un score à un panier était écrite deux fois, une fois en SQL et une fois en TypeScript. C’est le même piège que l’invariant client-serveur, appliqué au couple base-service. Changer le nombre de paniers d’un seul côté aurait fait afficher des chiffres différents à l’écran de fin de partie et au rapport d’historique, sans faire rougir un seul test. La correction a déplacé le calcul en SQL également, appelé par l’écrivain, le lecteur et le semoir, si bien qu’aujourd’hui la règle vit à un seul endroit.
Et comme pour le classement, le choix est ici annoncé plutôt que caché : une reprise compte comme une nouvelle partie dans l’histogramme. Je l’ai mesuré : votre centile monte sans que vous progressiez, de 50 % à 58 % après quatre tentatives plus mauvaises sur une journée fraîchement semée. Le jour de l’audit, j’ai décidé de l’accepter. Le corriger supposerait de soustraire vos propres parties côté client, c’est-à-dire de faire confiance au client sur un chiffre public — précisément le raccourci que le rejeu côté serveur existe pour éviter.
Savoir combien jouent sans savoir qui
Le 24 août, la même règle atteint le comptage d’usage. Verbris n’a ni Google Analytics, ni cookies, ni bandeau de consentement, et non pas parce que personne ne regarde les chiffres : la façon dont je les regarde est conçue pour ne pas pouvoir identifier quiconque, même si je le voulais.
Le principe est celui du centile, appliqué à une autre question : combien de personnes différentes ont joué aujourd’hui. Chaque événement — le début et la fin de chaque partie, tous modes confondus, avec un seul hook par côté dans le store — produit une empreinte à partir de l’IP, de l’agent utilisateur et d’un sel qui change chaque jour. Le sel n’est pas une table à faire tourner à la main : il est calculé à la volée depuis un secret fixe et la date du jour, si bien qu’à minuit il change tout seul. Le même visiteur le même jour produit toujours la même empreinte, ce qui suffit à compter les visiteurs distincts ; le lendemain le sel diffère et cette empreinte n’est plus reconstructible, donc suivre la même personne d’un jour à l’autre est impossible, parce que la fonction ne s’inverse pas.
Les seules lignes portant quoi que ce soit de dérivé d’une donnée personnelle sont jetées au bout de huit jours, à chaque exécution du script qui imprime le rapport. Le reste — combien de parties par mode et par langue — n’est qu’un compteur : aucune colonne ne peut contenir une identité.
Je l’écris ici plutôt que dans un journal de versions parce que c’est la troisième fois que la même question — puis-je obtenir ce chiffre sans identité en dessous ? — reçoit une réponse technique différente pour un problème différent. D’abord le score, avec l’histogramme. Puis les joueurs, avec l’empreinte éphémère. Ce n’est pas un principe écrit une fois puis copié-collé : c’est une question que je me suis reposée chaque fois qu’un chiffre collectif était nécessaire, et jusqu’ici la réponse a toujours été oui.
L’écran de fin de partie
S’il est un élément d’interface qui raconte tout le mouvement du projet, c’est celui-ci. Le 16 juin, la confirmation de sortie supprimée, arrive une refonte des statistiques avec des menus déroulants pour passer d’une vue à l’autre, des graphiques des huit derniers jours et un centile historique. La direction est ici l’inverse des suppressions : non pas moins de friction, mais plus de contexte. « Vous avez marqué 120 points » ne dit rien tout seul.
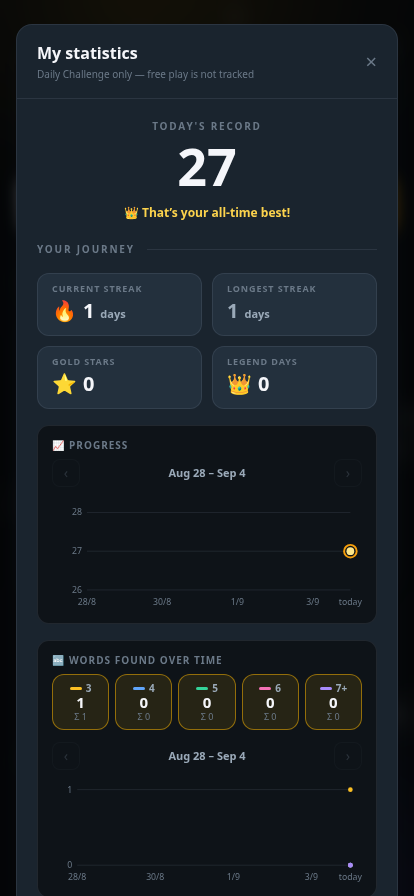 La fenêtre de statistiques aujourd’hui : série, étoiles, journées Legend et deux graphiques. C’est la même idée que le 16 juin, affinée.
Le dernier ajout date de début septembre : une célébration visuelle qui croît avec votre centile, d’autant plus festive que vous êtes bien placé. J’ai choisi de ne pas fixer de nombre minimum de parties avant de l’afficher, tout en sachant qu’aux premières heures du jour l’échantillon est petit et le chiffre généreux. Je préfère que quelqu’un qui joue à sept heures du matin ait droit à la célébration, et que le chiffre se stabilise de lui-même au fil de la journée.
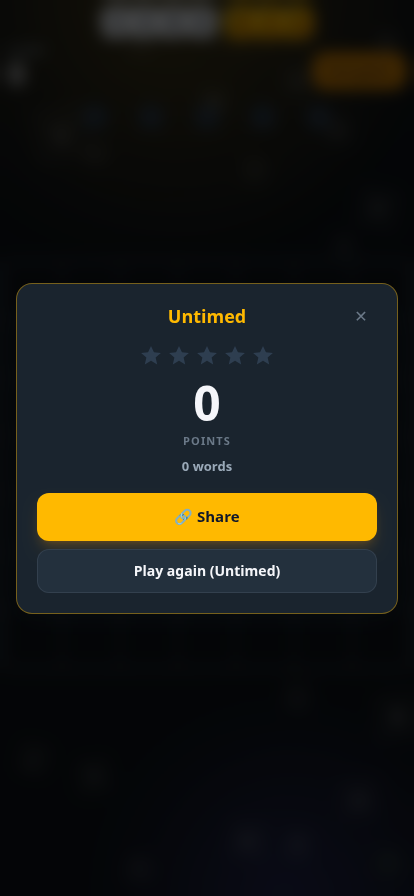 Le récapitulatif de fin de partie aujourd’hui, ici en Sans chrono et capturé sans avoir complété le moindre mot, d’où le score à zéro. Dans le Défi quotidien, le même composant affiche aussi le centile.
Les clips promo, un navigateur sans interface qui joue pour de vrai
Le 17 août, je pars de la route évidente pour qui dispose déjà d’un bot capable de jouer seul, le même qui calcule le par des étoiles : lui faire jouer des centaines de parties, retenir les meilleures selon des critères mesurables — la plus longue cascade, le plus haut score, le mot le plus rare — et les monter avec ffmpeg en trois formats, avec des comptes à rebours et des révélations dessinés sur des images figées. Cela fonctionnait, c’est parti en production, et c’est le pipeline que j’ai ensuite jeté : on voyait bien que personne ne jouait vraiment.
Son remplaçant, de fin août, est plus simple à décrire et plus difficile à obtenir. On enregistre une vraie instance du jeu pendant qu’elle joue, avec un Chrome sans interface piloté par Playwright. Ce qui rend cela possible sans inventer de faux endpoints ni traîner du code de tournage dans le bundle, c’est l’interception de la requête réseau par laquelle le client charge la quotidienne, à laquelle on répond avec une grille issue du pool Sans chrono plutôt que la vraie du jour. L’application croit jouer une quotidienne normale, avec un chronomètre qui tourne, de vrais coups et une vraie animation de sortie, et ignore qu’elle est sur un plateau. Le vrai backend n’est jamais contacté, si bien que la règle « jamais la quotidienne d’aujourd’hui ni de demain », pour éviter les divulgations, est garantie par le fait que la vidéo ne peut pas la voir, et non par une consigne à retenir.
Le chronomètre mérite une note, car c’est le détail le plus facile à rater : il démarre à 35 secondes au lieu de 15 pour laisser de la place aux appuis pendant l’enregistrement, et à l’instant où le dernier coup tombe il est forcé à zéro. Le compte à rebours visible dans la vidéo finale est antidaté volontairement ; il n’a jamais été le temps réellement écoulé.
La partie la moins évidente est la capture des images. La route techniquement la plus propre était la fonction native de Chrome prévue exactement pour cela, Page.startScreencast du protocole de débogage, celle qu’utilisent les outils de développement pour afficher un écran de téléphone émulé : chaque image arrive avec son propre horodatage, ce qui rend immédiat le placement d’un coup sur une seconde. Mesurer plutôt que supposer a révélé que cette fonction ignore la densité de pixels de l’appareil simulé et capture toujours à la résolution CSS de la fenêtre, 390 pixels de large, et non à la résolution réelle du téléphone imité, qui en fait le triple. C’est une limite de Chromium, vérifiée en pilotant aussi les commandes du protocole bas niveau à la main, et non une option qu’on passerait mieux.
Le 18 août, j’ai essayé l’alternative évidente : capturer image par image avec la capture d’écran ordinaire, qui respecte bien cette densité. Cela fonctionnait, mais coûtait près d’une demi-seconde par image, et sur un vrai enregistrement la fréquence s’effondrait de 59 à 4 images par seconde. Trop loin de la fluidité pour un fil que les gens font défiler en une seconde, et j’ai annulé ce changement deux minutes après l’avoir committé. C’est le genre de demi-tour qui vous coûterait l’orgueil de défaire des heures de travail écrit à la main, et qui, avec une IA qui réécrit en quelques minutes, est simplement le bon geste.
La solution retenue, dix jours plus tard et là encore mesurée, ne corrige pas la limite : elle la compense. Les images restent à la basse résolution imposée par Chromium, et l’agrandissement vers la résolution finale de la vidéo, près du triple, utilise Lanczos plutôt que le filtre bilinéaire par défaut de ffmpeg. Plus net à partir de la même source, sans inventer du détail que l’image ne contient pas. Ce n’est pas la solution élégante que j’aurais aimé raconter ; c’est la vraie, avec sa limite énoncée plutôt qu’enterrée sous un commentaire optimiste.
Le dernier tour de main concerne la variante où trois ou quatre mots sont choisis lettre par lettre en tapant plutôt qu’en glissant, suivie d’une tentative fausse répétée exprès avant la fin du temps. Ces séquences ne sont pas écrites à la main : un script hors ligne rejoue chaque coup avec le moteur même que le serveur utilise pour le rejeu, processMove, de sorte qu’il sait où sera chaque lettre une fois que la gravité et la réserve auront modifié la grille, et il le fait avec la graine que le client utilisera pendant l’enregistrement. Le chemin des appuis a l’air décidé sur le moment alors qu’il est précalculé exactement tel que le vrai moteur le verra, mots faux compris : de vrais tracés sur la grille que le jeu rejette réellement, et non des appuis au hasard déguisés en erreurs.
Les vidéos sortent prêtes pour YouTube, Instagram et TikTok, avec des légendes tirées d’un ensemble de variantes pour que la même n’apparaisse jamais deux fois de suite, et l’une des quatre animations de sortie de grille tirée au sort, la même que celle que voient les joueurs.
Un vrai bug : le fond qui ralentissait tout
Le 28 août arrive un signalement sans détour : le jeu rame, aussi bien pendant le glissement des lettres que pendant la cascade qui suit un mot. La première hypothèse, des composants React qui se redessinent plus que nécessaire, était vraie mais insuffisante. J’ai corrigé quatre composants qui s’abonnaient à tout l’état du jeu au lieu des seuls champs qu’ils utilisaient vraiment — un chronomètre se mettant à jour quatre fois par seconde redessinait des panneaux qui n’affichent même pas l’heure — et le jeu restait lent.
La mesure qui a trouvé la cause ne comptait pas les rendus, elle comptait les images. À l’arrêt, sans rien toucher, l’écran de jeu tournait à 25 images par seconde au lieu de 60. Le goulot n’était pas l’interaction : c’était quelque chose qui consommait du processeur en continu, sur tous les écrans, même derrière une fenêtre fermée.
C’était le fond décoratif : deux halos semi-transparents dérivant lentement derrière chaque écran, avec un flou de 70 pixels appliqué sur un élément animé. Une translation ou un zoom, le processeur graphique les calcule presque gratuitement, en composant des couches qu’il possède déjà ; un flou de cette taille, animé, force le navigateur à refaire le flou de toute la zone à chaque image au lieu d’une seule fois. Le flou retiré et remplacé par un dégradé qui s’efface vers la transparence — le même effet à l’écran — on revient à 60 images à l’arrêt, 21 à 52 pendant un vrai glissement, et 23 à 55 pendant la cascade qui suit un mot accepté.
Ce qui m’a appris quelque chose n’est pas le correctif, c’est l’endroit où se trouvait le bug. Je cherchais la lenteur dans le code qui réagit au geste du joueur — sélection, validation, chute des lettres — et le coupable ne réagissait à rien : il tournait tout le temps, en dessous de tout, dès l’ouverture de l’application. Depuis, quand quelque chose semble lent pendant X, la première question que je pose n’est pas ce que X fait de travers, mais ce qui tourne même quand je ne fais pas X.
Verbris aujourd’hui
Trois mois et 828 commits après le premier, voici où il en est. Le thème sombre est le thème par défaut depuis le début, et je ne l’avais plus montré de près depuis la refonte de juin.
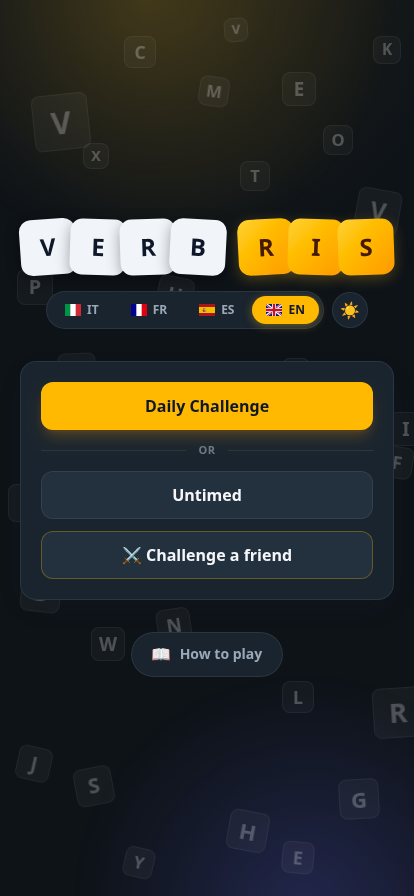 La page d’accueil aujourd’hui : les modes en entrées de menu, thème sombre.
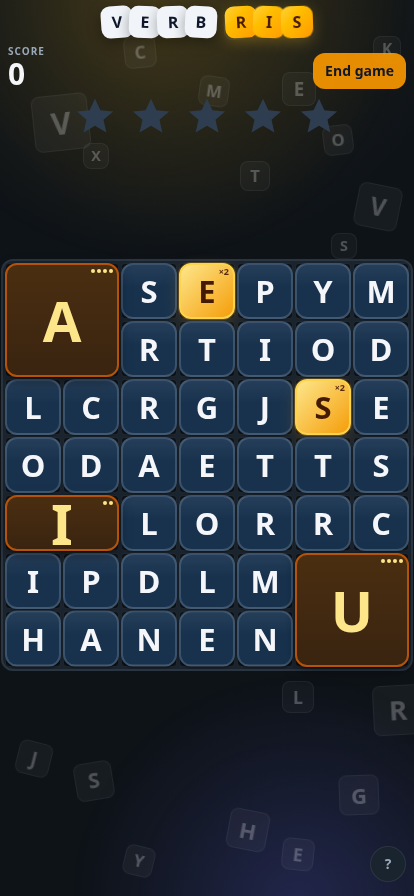 La grille de jeu aujourd’hui.
Le thème clair
La dernière étape visuelle, en place depuis août : un thème clair complet. Non pas un filtre posé sur les couleurs existantes, mais fond, tuiles, panneaux et états redessinés pour les deux thèmes.
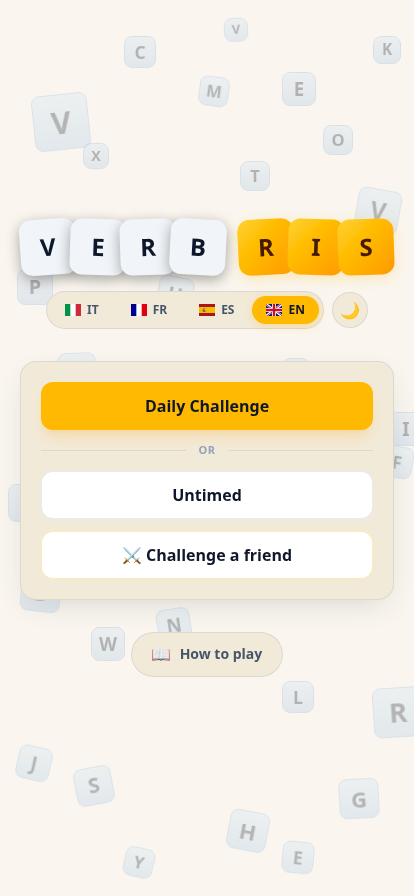 La même page d’accueil aujourd’hui, en thème clair.
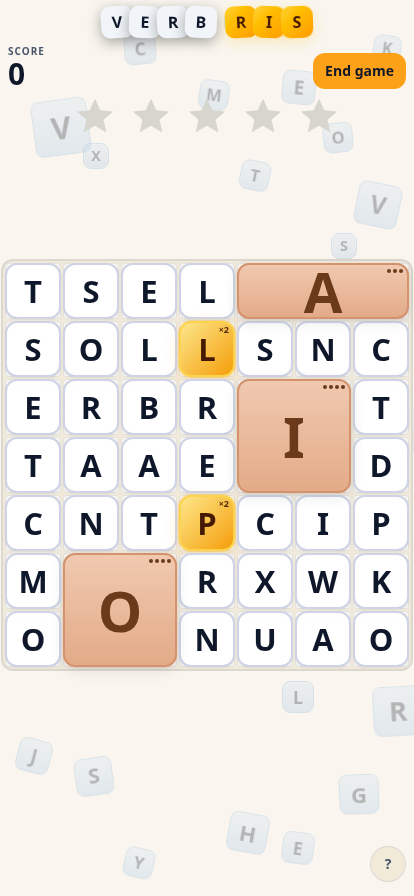 La grille de jeu en thème clair.
En chiffres
- 828 commits du 4 juin au 2 septembre 2026, aucun écrit à la main.
- 459 en juin, 335 en août. Juillet compte le moins de commits et les décisions les plus lourdes.
- 45 specs, 45 plans, 16 audits de code.
- Une vingtaine de commits qui retirent ou défont quelque chose de déjà construit.
- 5 modes de jeu sur un seul moteur, en italien, français, espagnol et anglais.
- Environ 2 600 indices écrits à la main pour Cruciverbris et 204 listes thématiques.
- 463 tests frontend, 16 backend, plus le filet de non-régression du générateur.
Trois mois plus tard
Je n’ai pas utilisé l’IA pour écrire du code plus vite que je ne l’écrirais moi-même. Je l’ai utilisée pour pouvoir me permettre de changer d’avis. Construire la connexion, les amis et le classement en juin puis les jeter en août, en écrivant chaque ligne à la main, aurait représenté des semaines brûlées sur un pari produit : en pratique je ne l’aurais pas fait, j’aurais tout gardé et appelé feuille de route mon incapacité à trancher. Quand une spec devient du code fonctionnel en quelques heures, ce calcul change, et la contrainte se déplace : ce n’est plus la vitesse d’écriture, c’est la discipline avec laquelle on décide de ce qu’on garde. Les 45 specs et les 16 audits sont là pour ça.
L’architecture de fond — code partagé entre client et serveur, déterminisme, modes comme données — je n’ai jamais eu à la réécrire. Tout le reste, si : le nom, l’authentification, le modèle de score, l’interface quatre fois. C’est pourquoi le « un mois » du titre n’est pas un artifice : c’est le temps qu’il a fallu pour obtenir un moteur assez solide pour porter deux mois de remises en question par-dessus.